共计 2878 个字符,预计需要花费 8 分钟才能阅读完成。
先说结论:这套 SCM 系统现在有 15 项功能 在跑——12 项已经进了日常工作流,3 项(长期采购时间轴、Amazon 核验、智能补货)属于 ” 参考与验证 ”,不当作自动执行依据。另外还有 1 个 AI Agent 模块 正在落地:界面原型能走通、方案和样例都齐了,但后端还没上线。
一、先看清全局:功能不是一样成熟
老板看系统最容易踩的坑,是把 ” 页面上有 ” 当成 ” 可以照着做 ”。所以这里先给一张成熟度分层图:哪些数字可以直接下判断,哪些只能当参考,哪些还在验证。
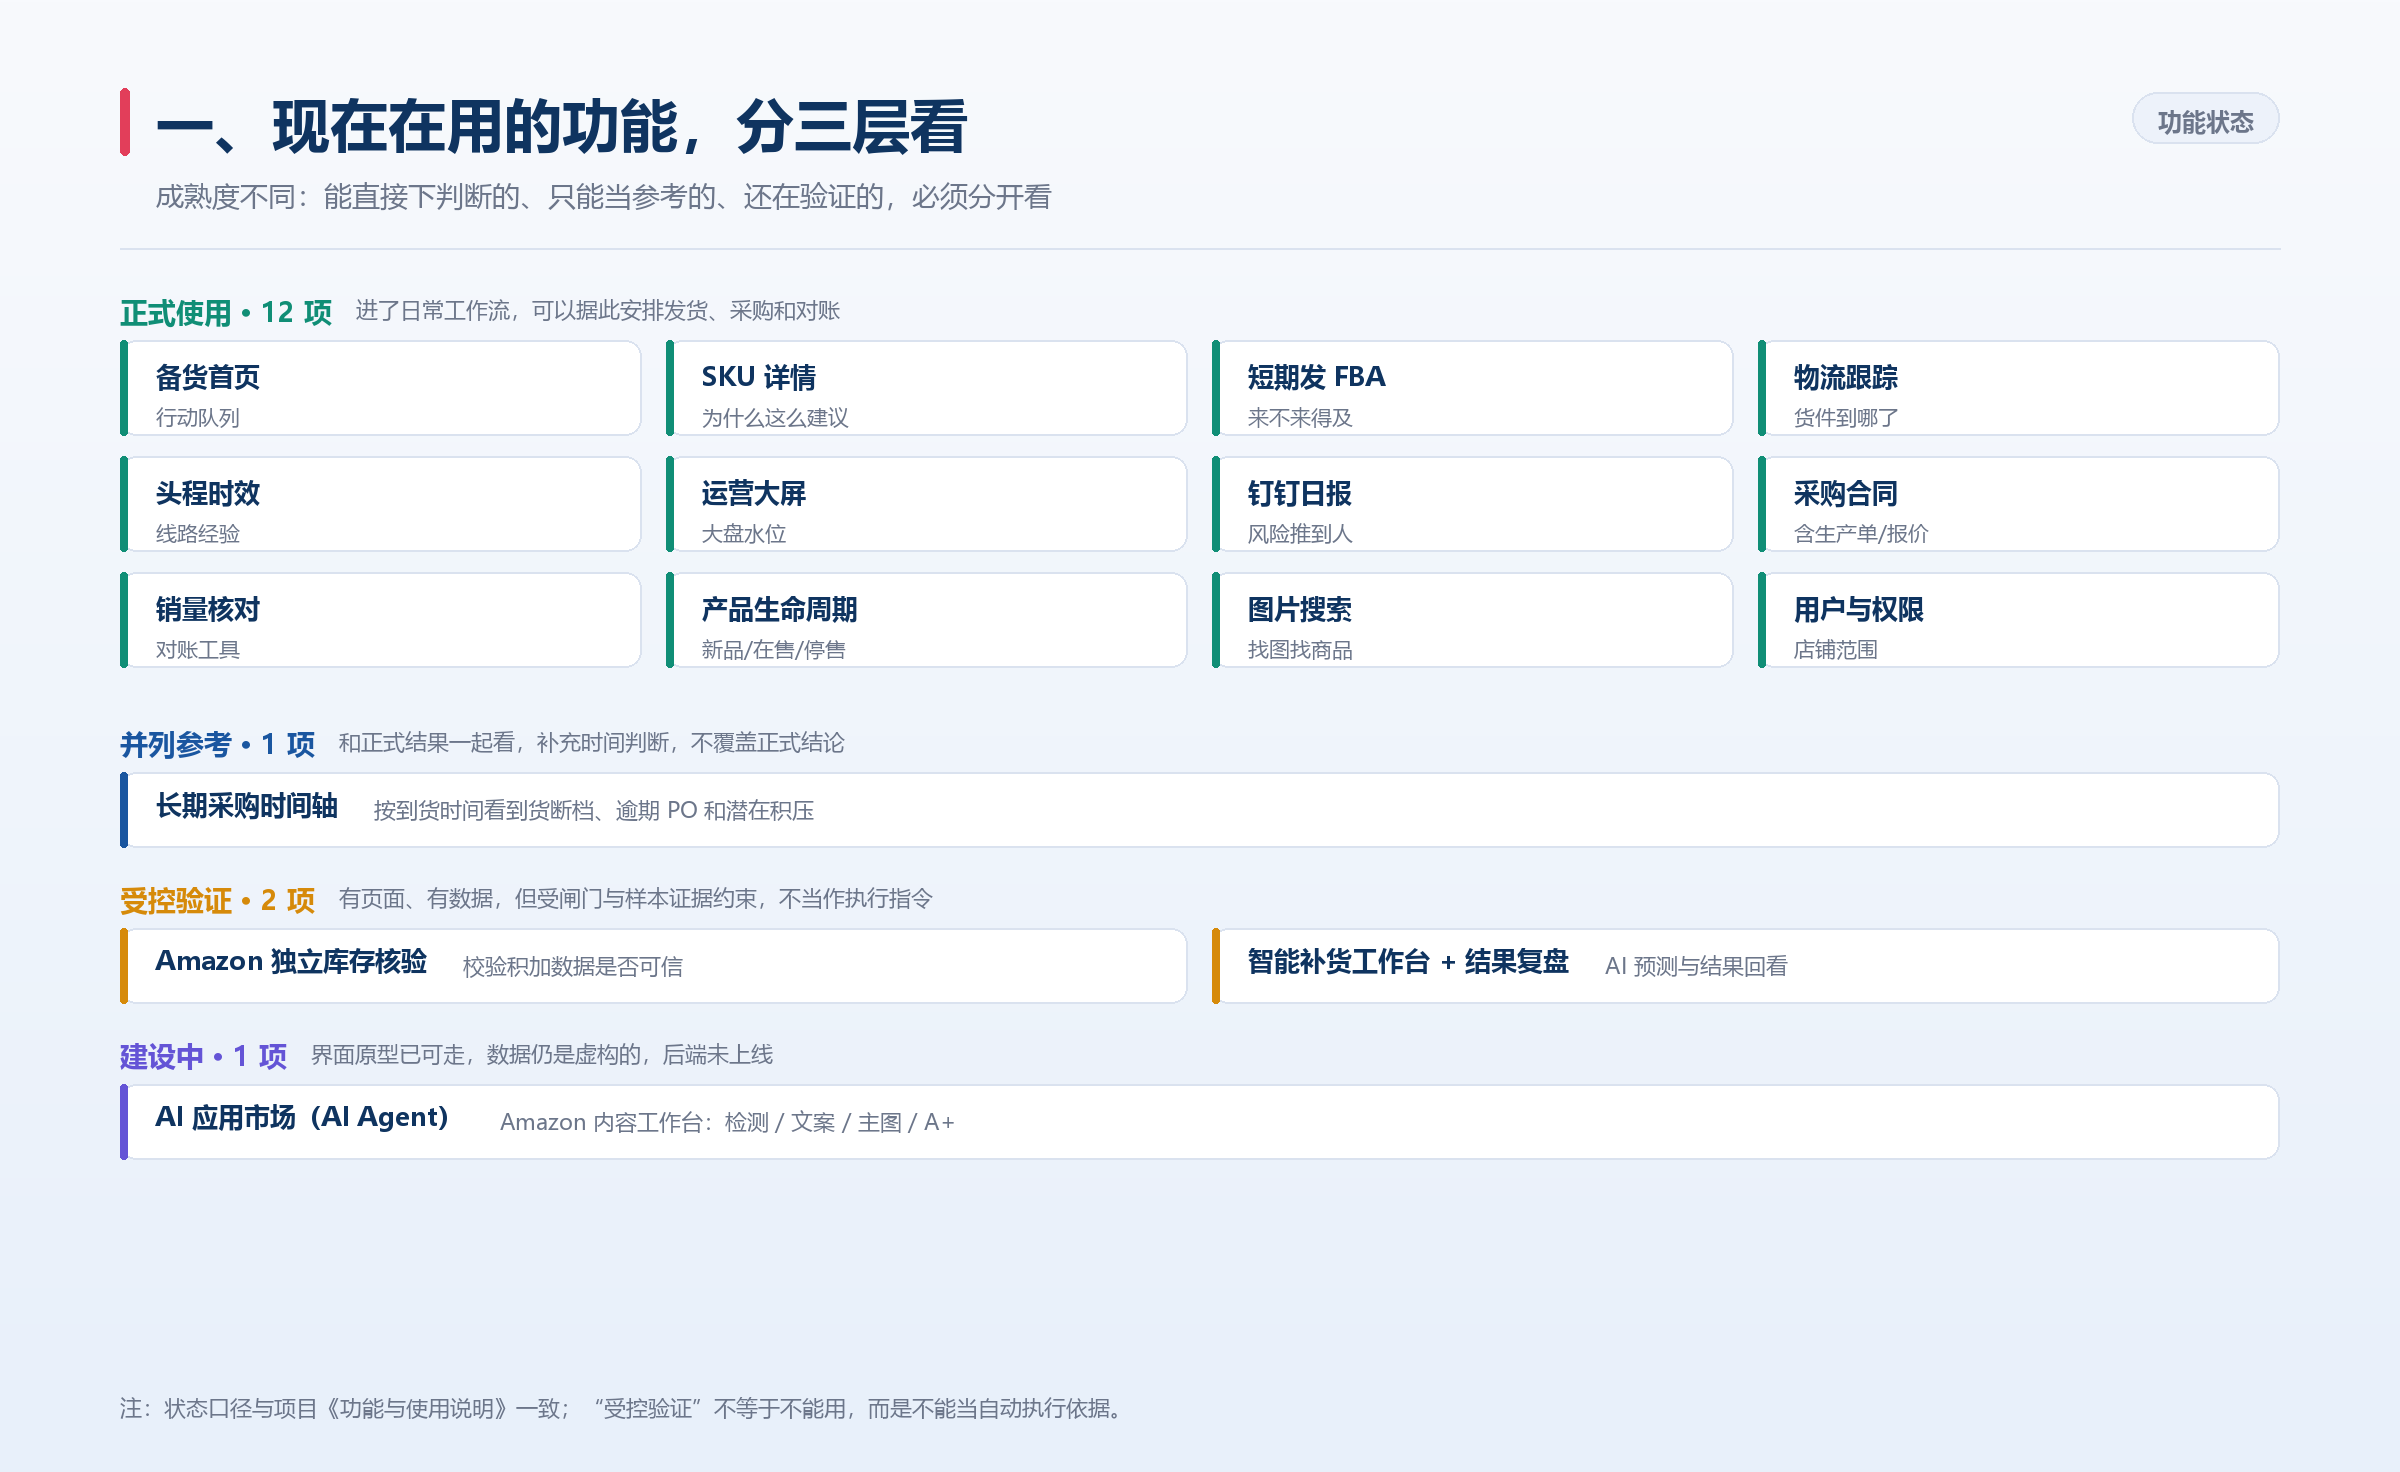
为什么必须分这么细?因为供应链的错不是 ” 页面卡一下 ” 的错,是 ” 多发一个柜、少发一个柜 ” 的错。系统的原则是:证据不足时宁可阻断,也不给一个看起来很确定的数字。
二、15 项功能,逐条说清楚
| 功能 | 状态 | 解决什么问题 |
|---|---|---|
| 备货首页 | 正式使用 | 今天先处理哪些 SKU——发货、复核、采购三个队列,一眼分优先级 |
| SKU 详情 | 正式使用 | 为什么是这个建议——销量、供给、时间、原始明细逐层展开 |
| 短期发 FBA | 正式使用 | 海外会不会断、国内现在发能不能赶上,给出缺货日与线路时效 |
| 物流跟踪 | 正式使用 | 货件走到哪了,失败、超时未更新、待确认的货件集中呈现 |
| 头程时效配置 | 正式使用 | 把线路经验变成可计算的到货区间,不再靠拍脑袋估算 |
| 运营大屏 | 正式使用 | 大盘水位与风险分布,管理层开会直接投屏 |
| 钉钉日报 | 正式使用 | 早上把重点风险推到具体的人,不用等人自己登录找 |
| 采购合同 / 生产单 / 报价 | 正式使用 | 从 ” 建议采购 ” 直接进到单据,减少二次录入和口径错位 |
| 销量核对 | 正式使用 | 卡片销量和明细为什么对不上,现场重算逐项比对 |
| 产品生命周期 | 正式使用 | 新品、在售、停售走不同策略;停售强制停止自动补货 |
| 图片搜索 | 正式使用 | 按图找商品和业务图片,查重、找素材不用问人 |
| 用户与店铺权限 | 正式使用 | 谁能看哪些店铺、谁能改配置,全部有边界和审计 |
| 长期采购时间轴 | 并列参考 | 按到货时间看到货断档、逾期 PO、日期不明供给和潜在积压 |
| Amazon 独立库存核验 | 受控验证 | 用 Amazon 官方报表校验积加数据是否可信,结果写在独立表、独立页 |
| 智能补货 + 结果复盘 | 受控验证 | AI 预测与结果回看,用于积累证据,不覆盖正式备货结果 |
注:同一 SKU 可能同时命中 ” 发货、复核、采购 ”,三个队列的数量 不能相加——它们是三类不同动作,不是三份缺口。
三、为什么有三项 ” 不全放开 ”
这不是技术没做完,而是这三项都属于 ” 结论会影响钱的判断 ”,必须先在真实数据上跑出证据:
- 长期采购时间轴 依赖 PO 到货日期和物流时点,而这两类数据本身就常有不明确的情况。系统会把 ” 日期不明 ” 的供给单列出来,而不是猜一个日期塞进计算。
- Amazon 库存核验 只做 ” 校验 ”,不做 ” 替代 ”:官方报表必须双表 join 才产出库存结论,避免单表口径造成误判;结果落独立表、独立页面,不混写正式备货数据。
- 智能补货 是影子模式——AI 给建议、系统记录它对不对,但正式结果仍由现有备货计算产出。这是刻意的隔离:新模型不能靠 ” 看起来更聪明 ” 就接管老流程。
换句话说,这三项的价值是 先把不确定的地方标出来,而不是提前给老板一个漂亮的数字。
四、重点:AI Agent 模块到底是什么
先破两个常见的误会:
它不是 ” 让 AI 接管备货 ”。补货预测仍由现有备货计算负责,Agent 不做第二套预测——否则两套结论打架,业务不知道该听谁的。
它也不是一个聊天框。首期是固定的业务流程:选商品、跑一次、出候选稿、人确认、导出。没有 ” 随便问点什么 ” 的入口。
它实际是系统里的一个 AI 应用市场(Agent 中心):员工看到的是图标和名称,管理员决定谁能用、能用多少预算。第一个上架的应用,是 Amazon 内容工作台——把 Listing 相关的重复判断交给系统做。
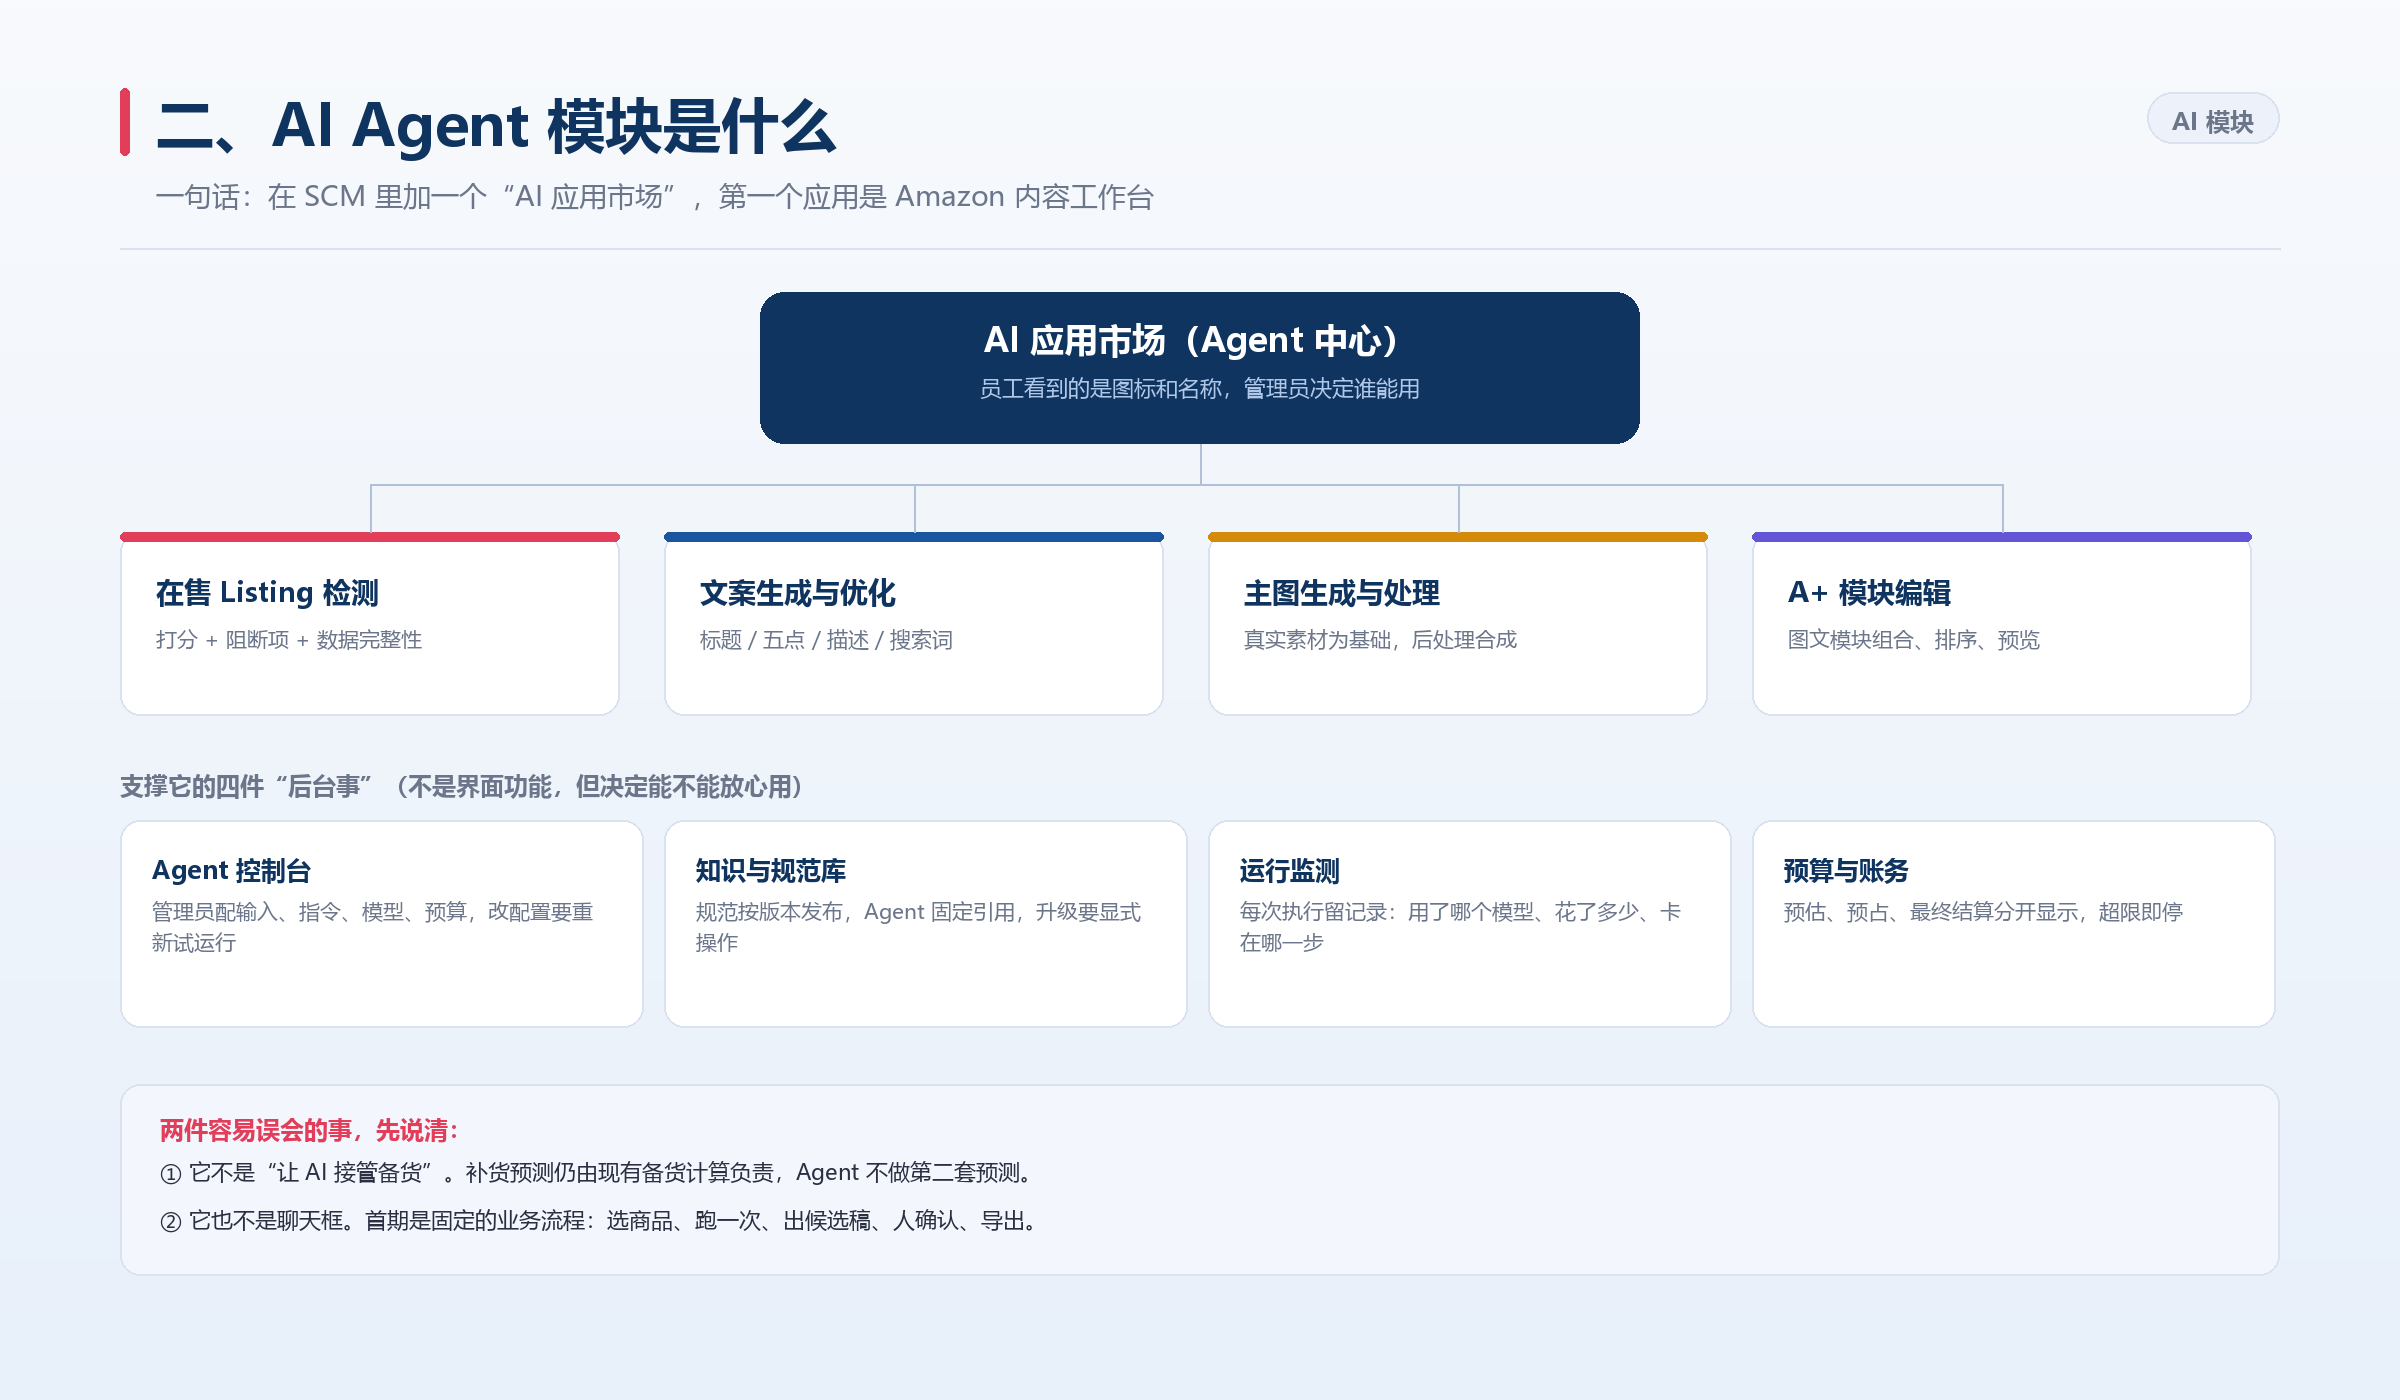
为什么要从 Listing 开始,而不是从补货开始?因为 Listing 是 可回退、可对比、错了不影响发货 的地方:标题写成什么样,不至于让某个仓断货,但它每天都在消耗运营的时间。用它当第一块试验田,风险最小、收益最直接。
五、它怎么跑:一次执行七步,每步留痕
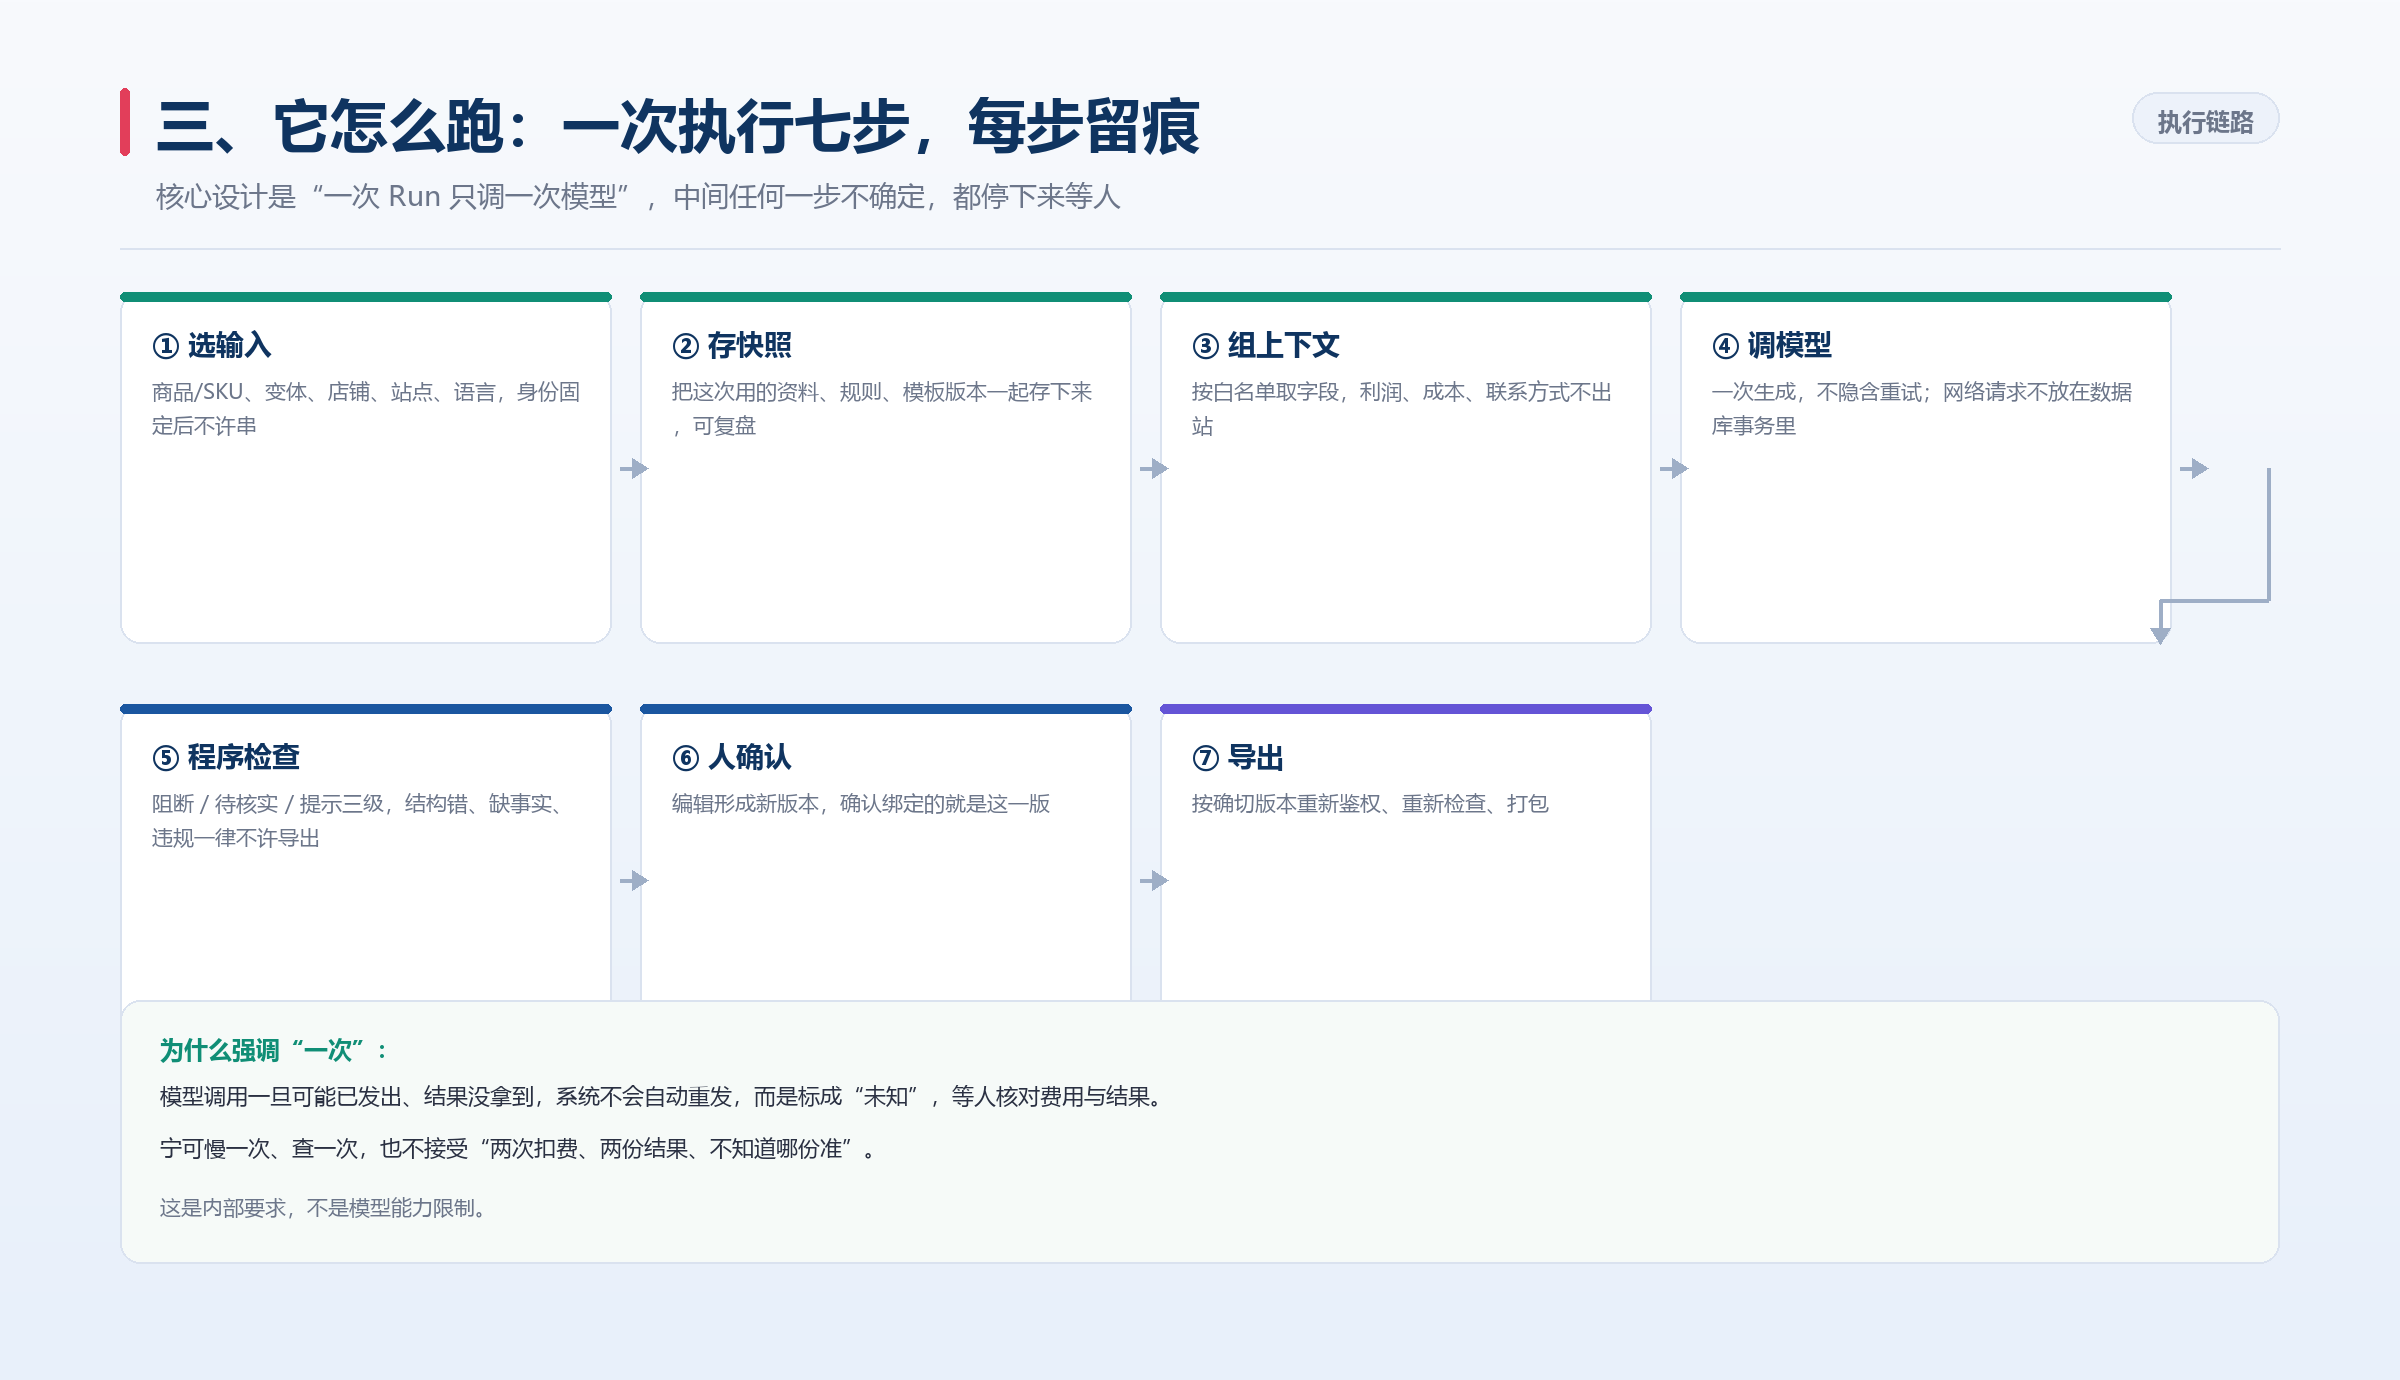
这套链路里,有几个设计是刻意 ” 反效率 ” 的:
- 一次 Run 只调一次模型。超时、被截断、格式不对,都不自动重发。宁可慢一次、查一次,也不接受 ” 两次扣费、两份结果、不知道哪份准 ”。
- 每份产物绑死版本。人编辑之后会生成新版本,导出时按确切版本重新鉴权、重新检查——不会出现 ” 确认的是 A、导出的是 B”。
- 检查靠程序,不靠模型的自我评价。结构损坏、缺必需事实、确定性违规,单独阻断,不能用 ” 总分很高 ” 盖过去。
六、诚实说进度:已就绪和没上线
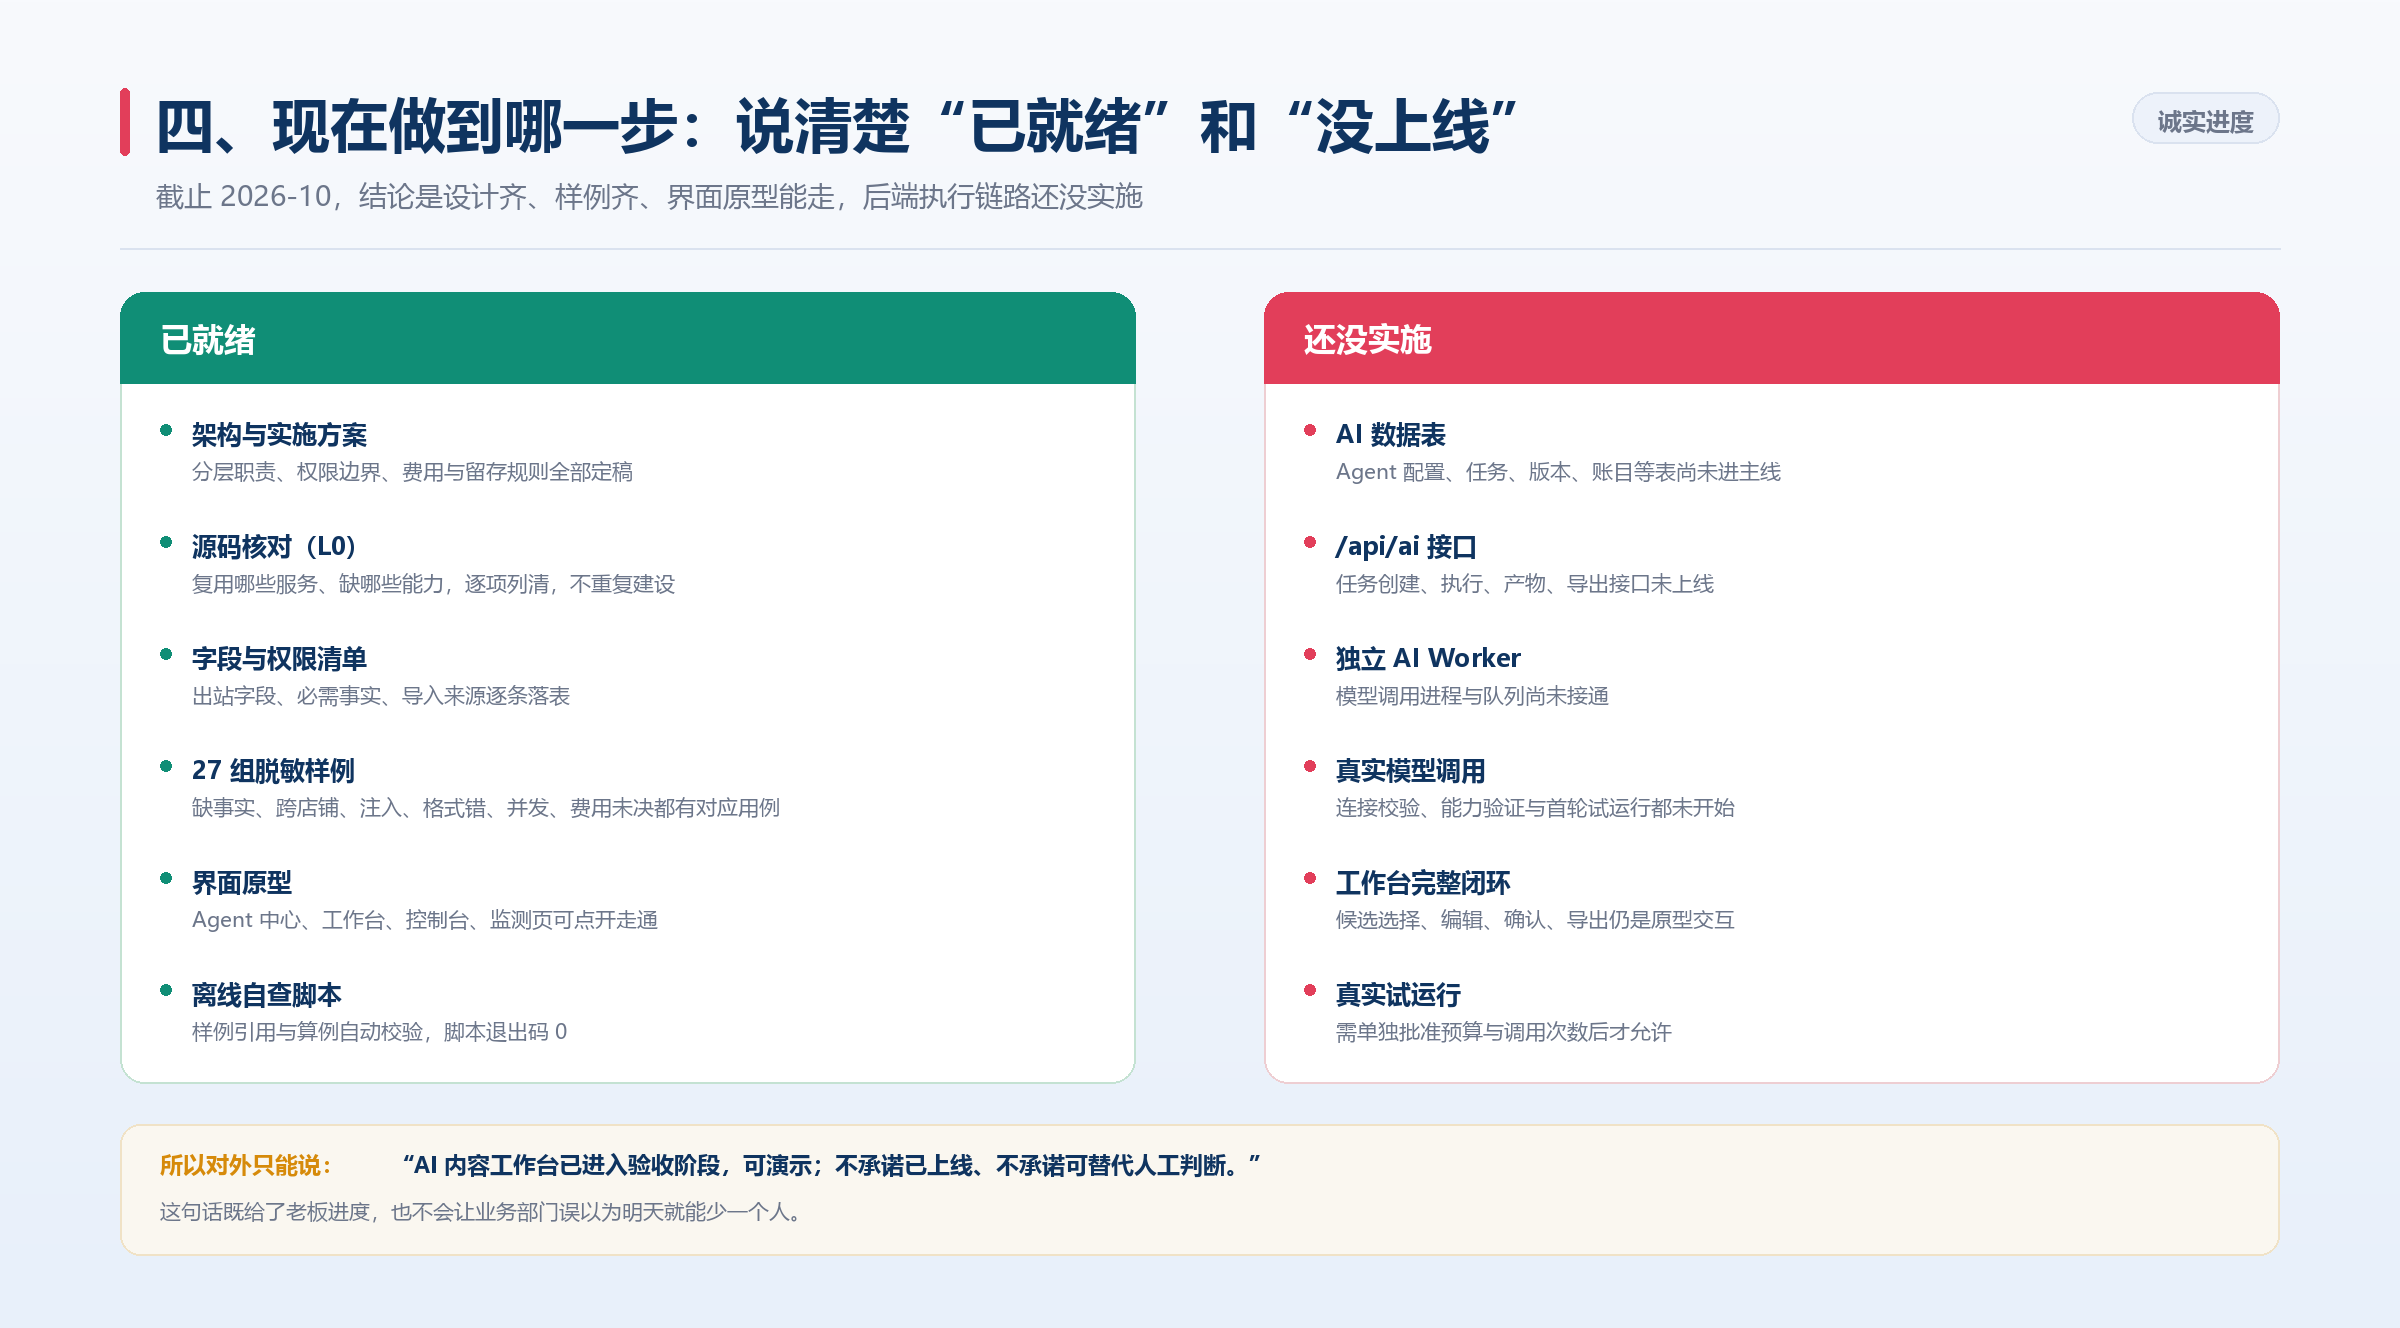
到现在为止,AI Agent 模块的资产是实的:
- 架构与集成实施方案定稿,分层职责、权限边界、费用与数据留存规则全部写明;
- 源码核对(L0)完成,逐项确认 ” 哪些现有服务可以复用、哪些能力必须新建 ”;
- 出站字段与权限清单落表,能出去的字段和绝不能出去的字段(成本、利润、供应商联系方式、凭据)分开标注;
- 27 组脱敏样例,覆盖缺事实、跨店铺、提示词注入、格式错误、并发、费用未决这些难看的场景;
- 界面原型可点开走通:Agent 中心、任务、工作台、控制台、监测页。
但必须说清:AI 数据表、/api/ai 接口、独立 AI Worker、真实模型调用、工作台完整闭环都还没上线;现在原型里的数据是虚构的。所以对外只能讲 ”进入验收阶段、可演示“,不能讲 ” 已上线、可替代人工判断 ”。
七、六道闸门:为什么它不会乱来
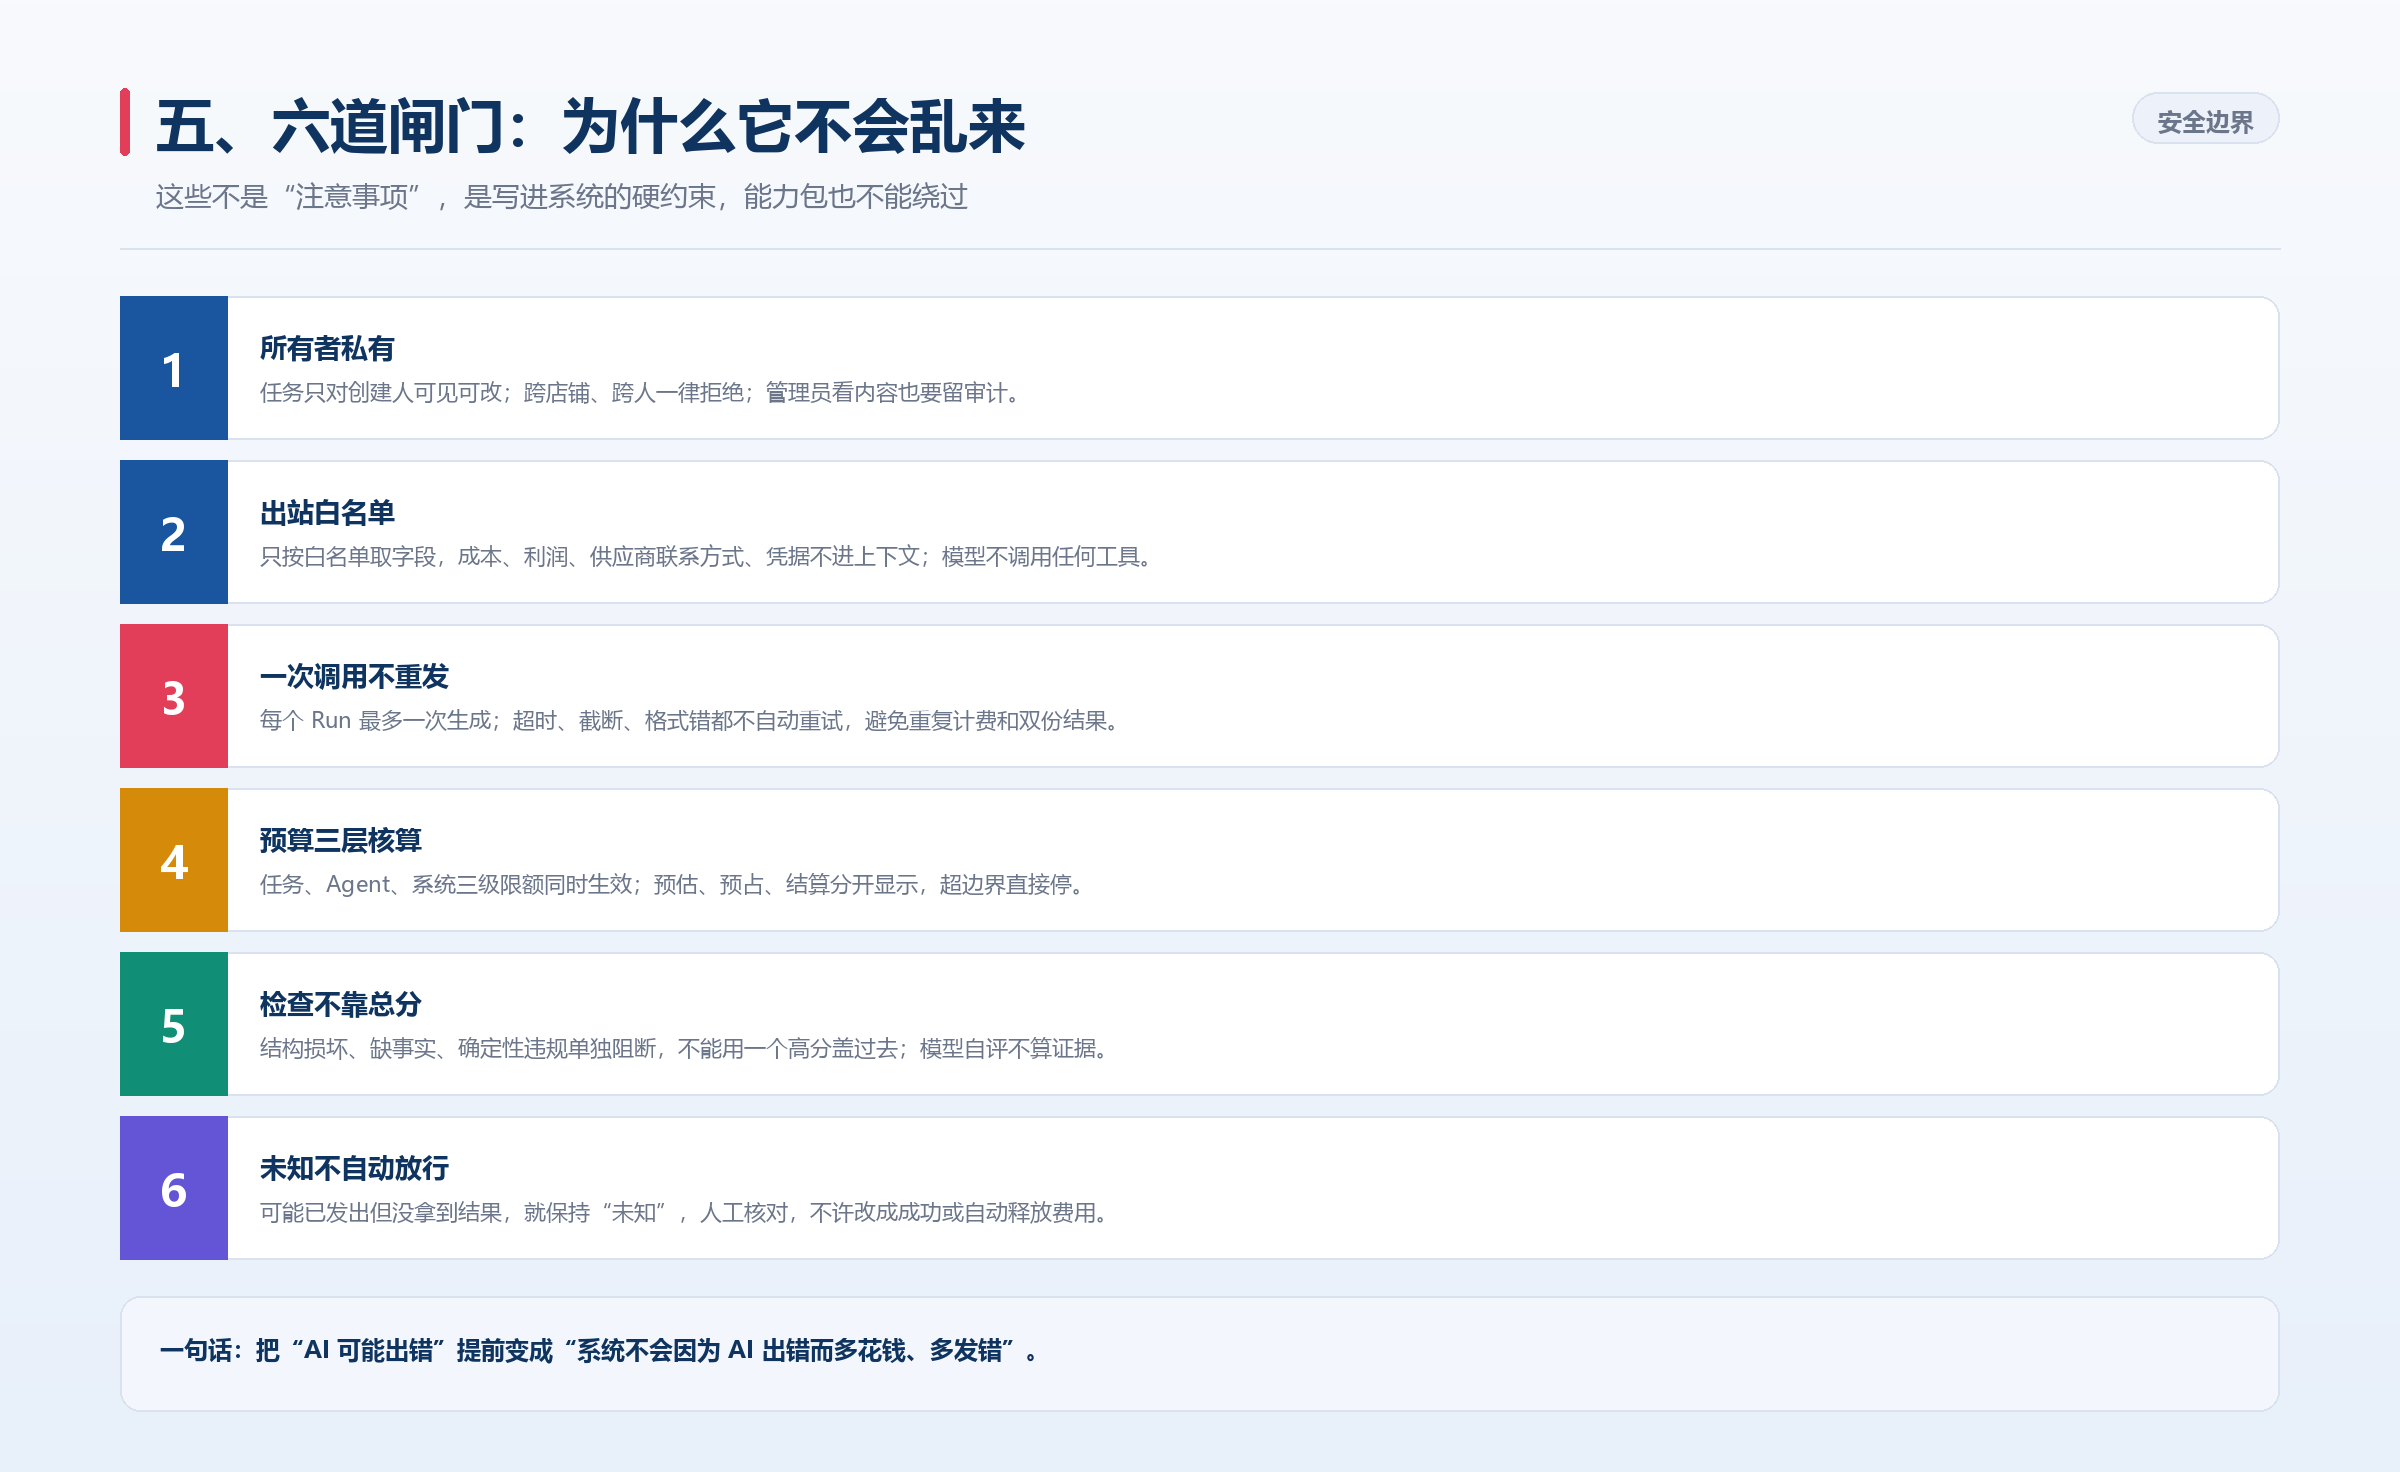
给老板看的版本,可以浓缩成一句话:把 ”AI 可能出错 ” 提前变成 ” 系统不会因为 AI 出错而多花钱、多发错 ”。
其中两条最能说明态度:
- 未知不自动放行。如果调用可能已经发出、但结果没拿到,系统把它标成 ” 未知 ”,人工核对费用与结果。既不改成功,也不自动释放预算。
- 预算三层核算。任务、Agent、系统三级限额同时生效,预估、预占、结算分开显示,任何一层超了就停。不是月底看账单,而是花之前就卡住。
八、未来规划:一条主线,先窄后宽
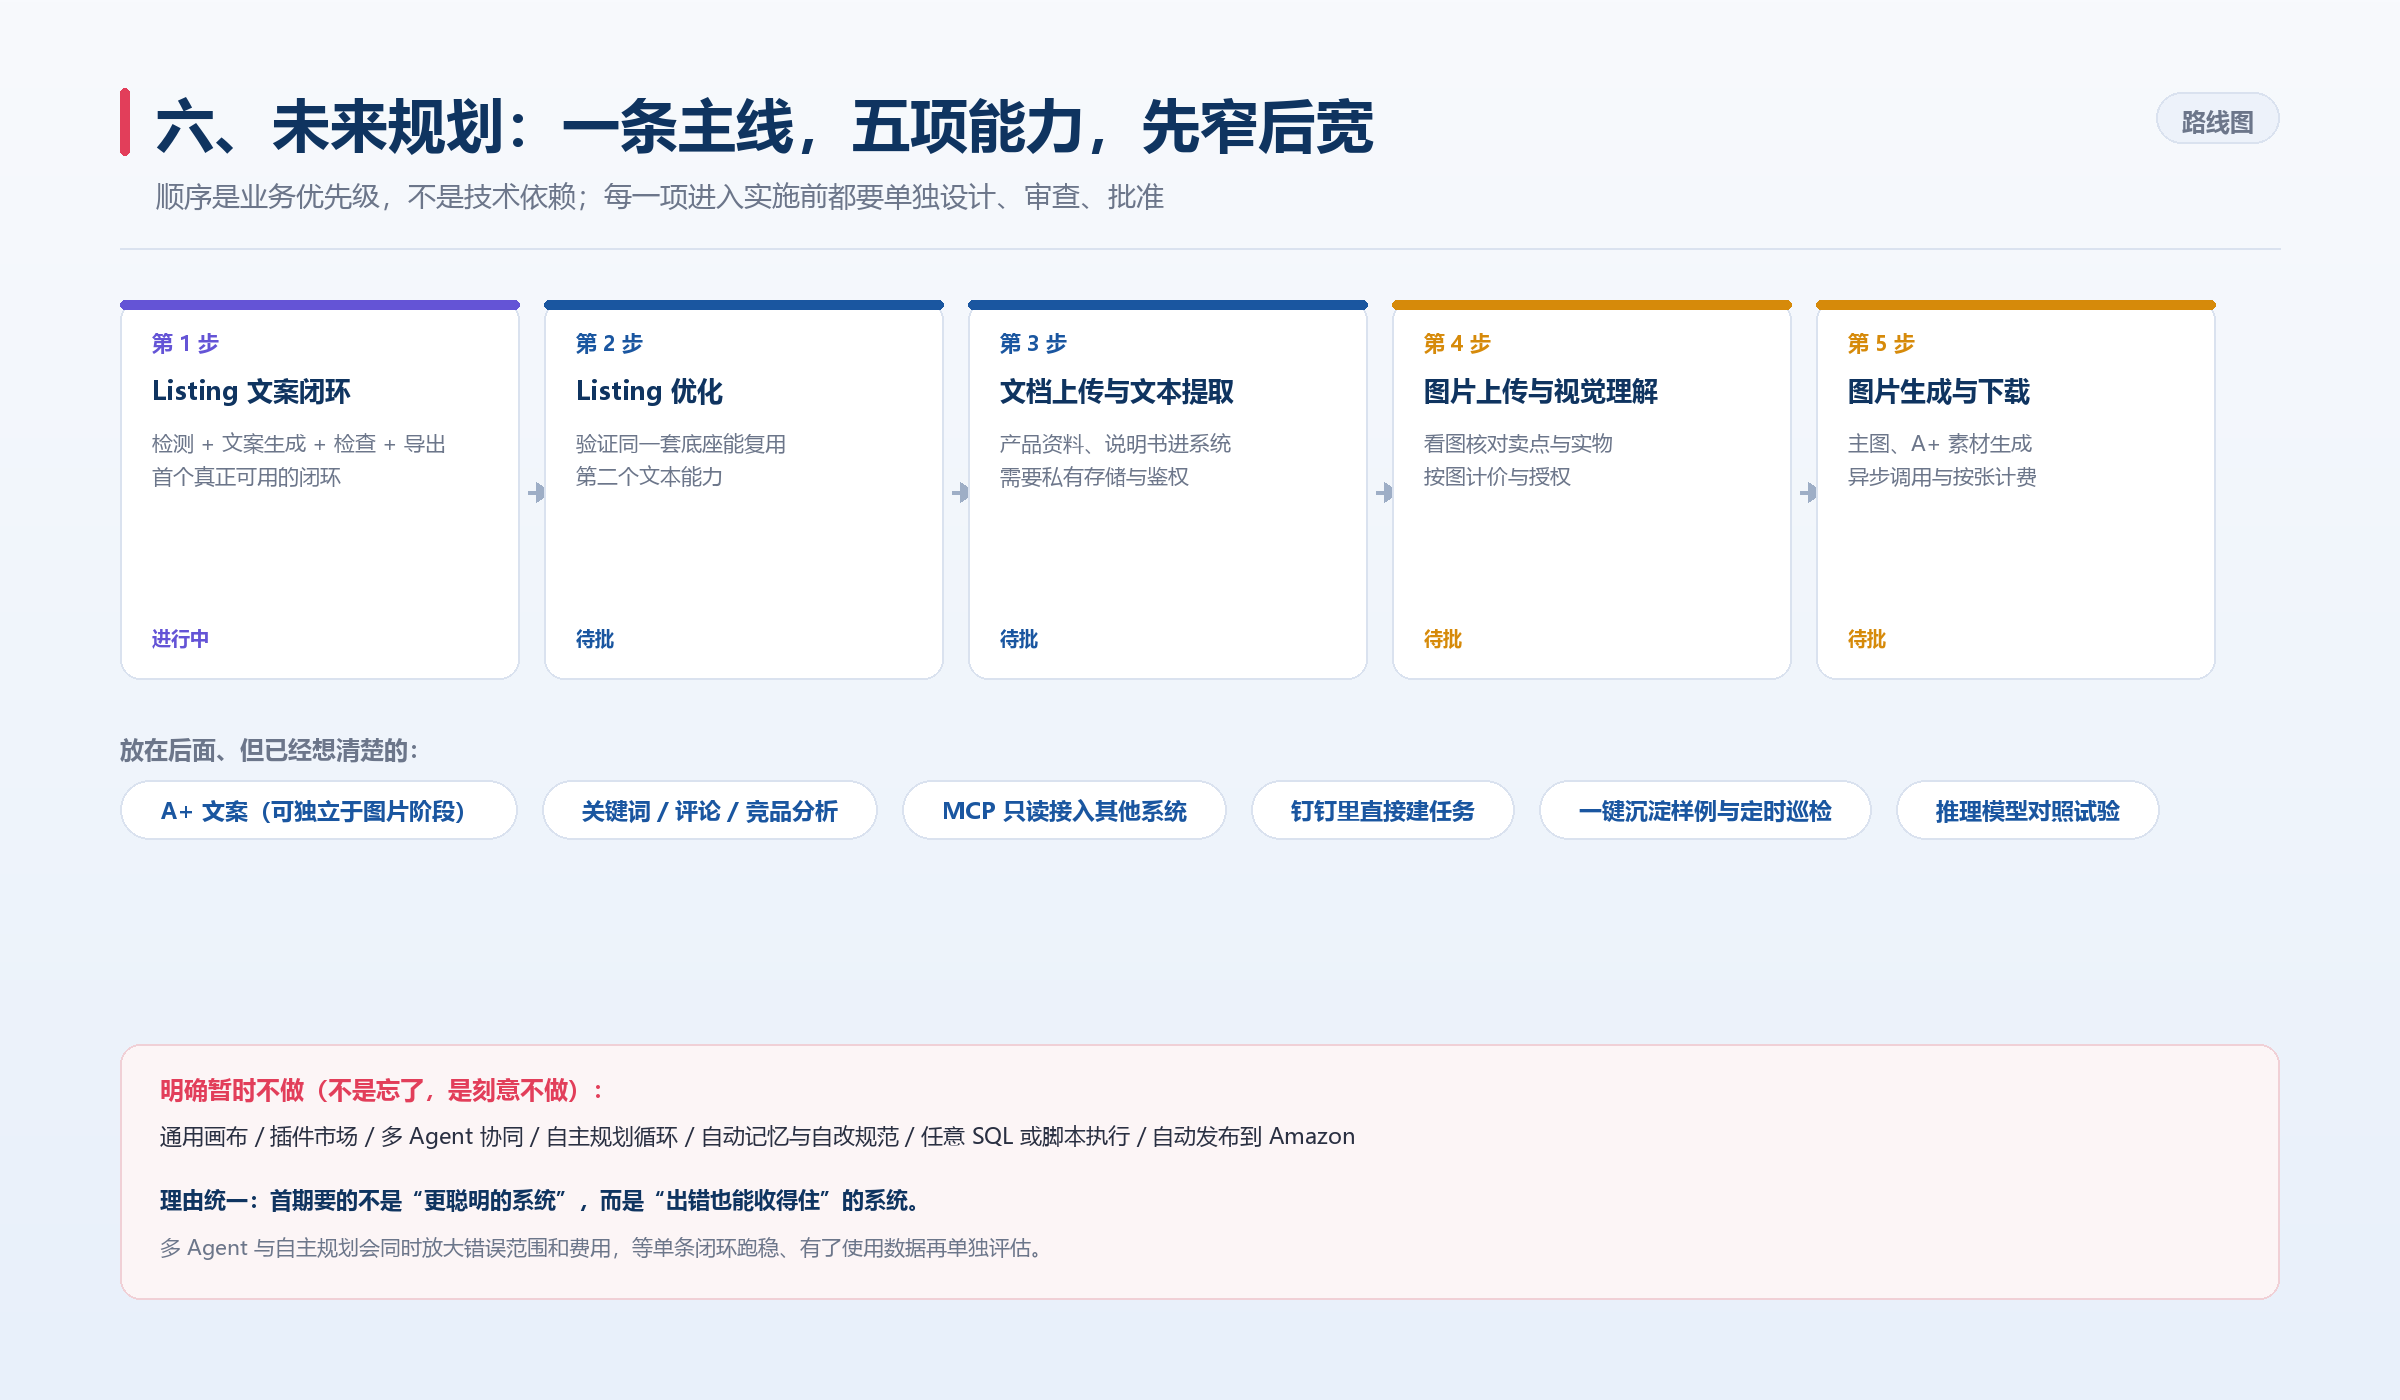
顺序的逻辑很清楚:先做纯文本、可回退、错了不影响发货的事;再逐步加入文档、图片这些需要私有存储和按量计费的环节。每一步都要单独设计、审查、批准,不打包一次性交付。
同步说明我们 刻意不做 的东西:通用画布、插件市场、多 Agent 协同、自主规划循环、自动记忆与自改规范、任意 SQL 执行、自动发布到 Amazon。理由统一——首期要的不是 ” 更聪明的系统 ”,而是 ”出错也能收得住“ 的系统。多 Agent 与自主规划会同时放大错误范围和费用,等单条闭环跑稳、有了使用数据再单独评估。
一句话收尾:现有的 15 项功能,已经把 ” 买多少、什么时候发、依据可不可信 ” 三件事串起来了;AI Agent 模块要接的下一棒,是把 重复的内容判断 也交给系统,人只保留最后那一下确认。进度该说的说清楚,不该承诺的不承诺——这比一个漂亮的演示更重要。
