共计 747 个字符,预计需要花费 2 分钟才能阅读完成。
国产大模型的竞争,正从模型层延伸到算力层:再强的模型,最终都要基于算子在芯片上执行。同一个模型、同一块芯片,换一套更优的算子,有时会带来数倍的性能提升。算子的效率决定了同样的显卡能跑多快,也决定了每个 token 的价格。
DeepSeek 近日全面开源推理框架 DeepInfer。继模型权重和 FlashMLA、DeepGEMM 等算子库之后,他们把模型运行的链路开放了。其中的 FlashMLA,有工程师在芯片上逐行手调的版本,算子性能跑到了硬件极限的 90% 以上,这也是人类手艺目前在部分芯片上达到的极限成绩。
而这个极限,同一周就被 AI 刷新了。据悉,截至 10 月 22 日,完全由 AI 编写算子、无人工逐行调优的 ForgeKernel,同时登顶两个算子评测榜:英伟达主场的 SOL-ExecBench FlashInfer-Bench 合集第一,以及昇腾 CANN 官方仓库维护的 CANNBench A3 硬件榜第一,基准加速比 1.835×,领先第二名 25%。在名次之外,AI 自主优化算子的能力不容小觑:在 DeepSeek v4.1 Flash 的算子上,相比 DeepSeek 开源的英伟达版本,ForgeKernel 也通过从 0 用 AI 迭代的方式实现了性能超越。
这是智能进化的接力。无论是 DeepSeek 的开源精神还是算子优化榜单的焦灼竞争,最终都导向同一个方向:让国产智能在每一块芯片上都跑得更快。
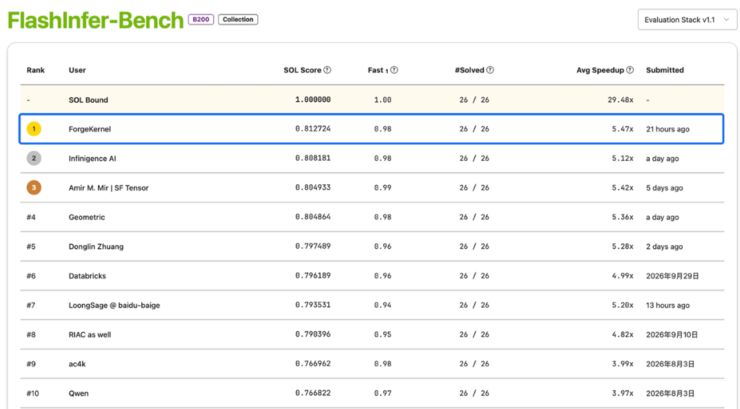
英伟达 SOL-ExecBench FlashInfer-Bench
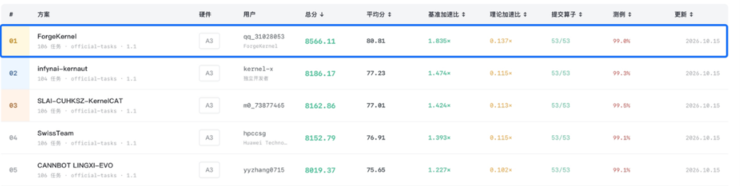
昇腾 CANNBench A3 硬件榜
来源:雷峰网
来源发布时间:2026-10-26T14:58:00+08:00(北京时间)
原文链接:https://www.leiphone.com/category/industrynews/IaMw7vRrTCadlbCY.html
