共计 498 个字符,预计需要花费 2 分钟才能阅读完成。
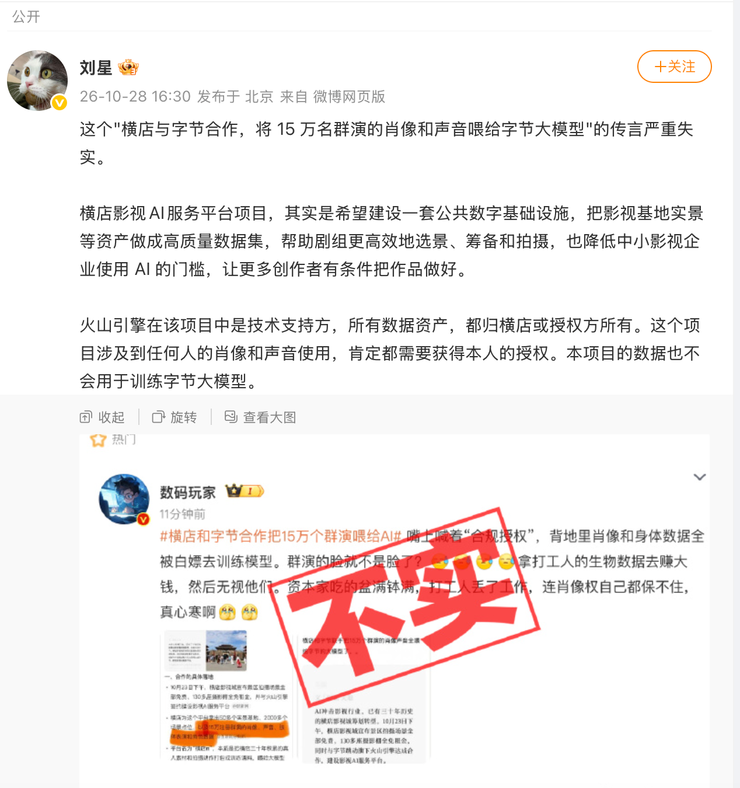
近日,有网络传言称 ” 横店与字节合作,将 15 万名群演的肖像和声音喂给字节大模型 ”。字节豆包公关负责人刘星今日通过微博作出回应,表示该传言严重失实。
据介绍,此次引发讨论的项目为横店影视 AI 服务平台建设项目。刘星表示,该项目的初衷是希望建设一套影视行业的公共数字基础设施,把影视基地实景等资产做成高质量数据集,帮助剧组更高效地选景、筹备和拍摄,同时降低中小影视企业使用 AI 的门槛,让更多创作者有条件把作品做好。
针对传言中的关键疑问,刘星澄清了三点:
第一,火山引擎在该项目中仅是技术支持方,所有数据资产均归横店或授权方所有。
第二,项目中涉及任何个人的肖像和声音使用,都需要获得本人授权,不存在未经授权采集的情况。
第三,本项目所采集的数据不会用于训练字节大模型。
公开资料显示,横店影视 AI 服务平台建设项目目前处于中标阶段,将围绕影视行业数据集建设、配套技术平台等业务展开。
来源:雷峰网
来源发布时间:2026-10-28T17:16:00+08:00(北京时间)
原文链接:https://www.leiphone.com/category/industrynews/kw1tPKZvQauDl4UJ.html
