共计 3461 个字符,预计需要花费 9 分钟才能阅读完成。
Jay 发自 凹非寺 量子位 | 公众号 QbitAI
坏,真让 MiniMax 给多模态玩明白了😭。
继开源视频旗舰 H3 广受好评后,最新的图像模型——H3-Image,再次席卷全网。
热度最高的是「CAD 拆解」,丢一张参考图,H3-Image 能给你小手办直接开盒了。。。
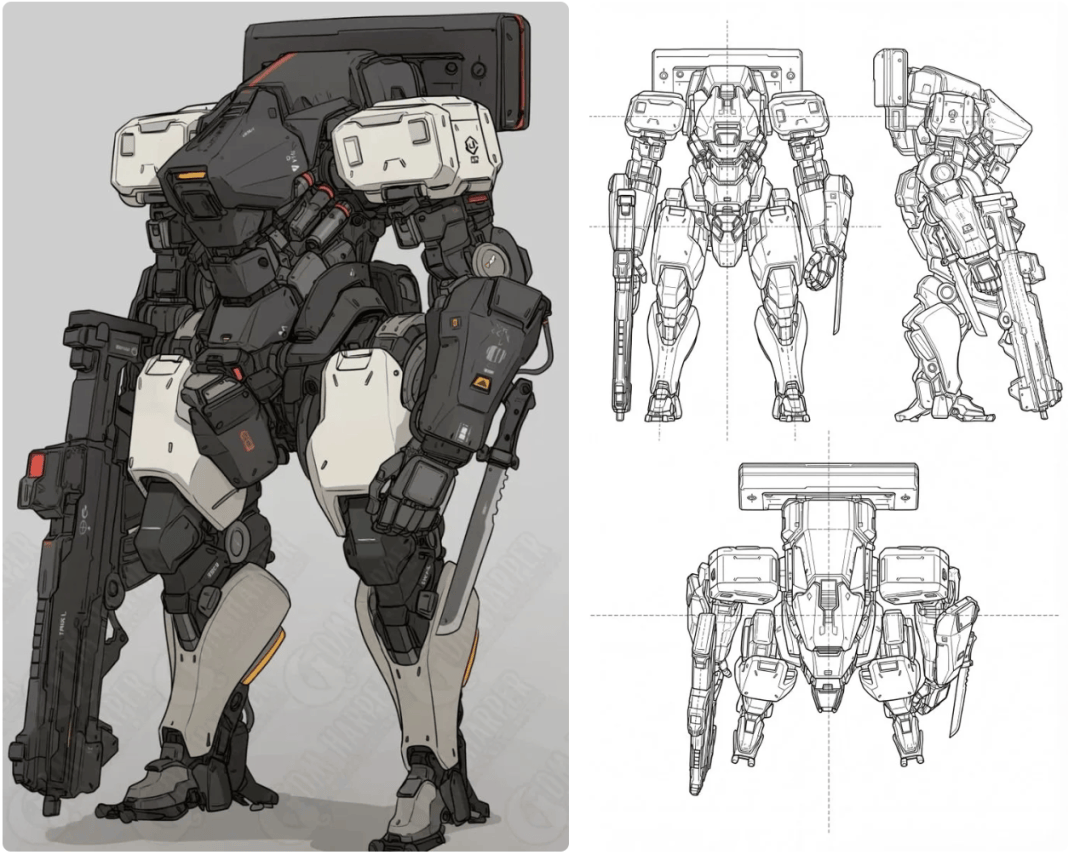
还有给 宇树机器狗CAD 了的。
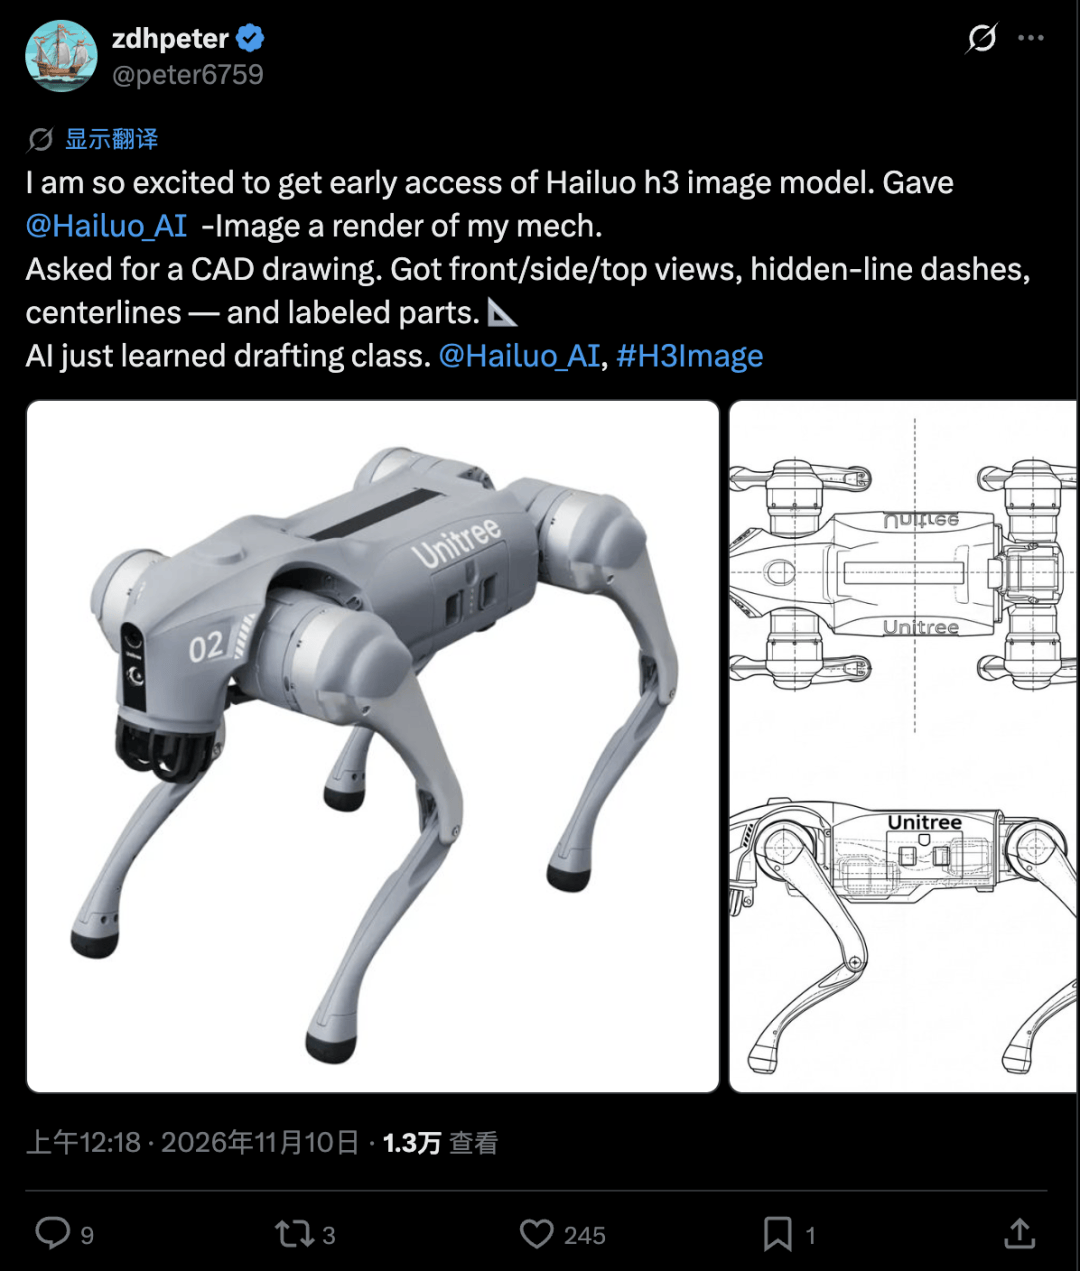
总之就是万物可拆解,还能给你把零件标好。
我自己也实测了一下,你还别说,真有点东西啊……
除此之外,海外网友测下来,其他类型的复杂生图任务也是能 Handle 住的,比如——游戏。
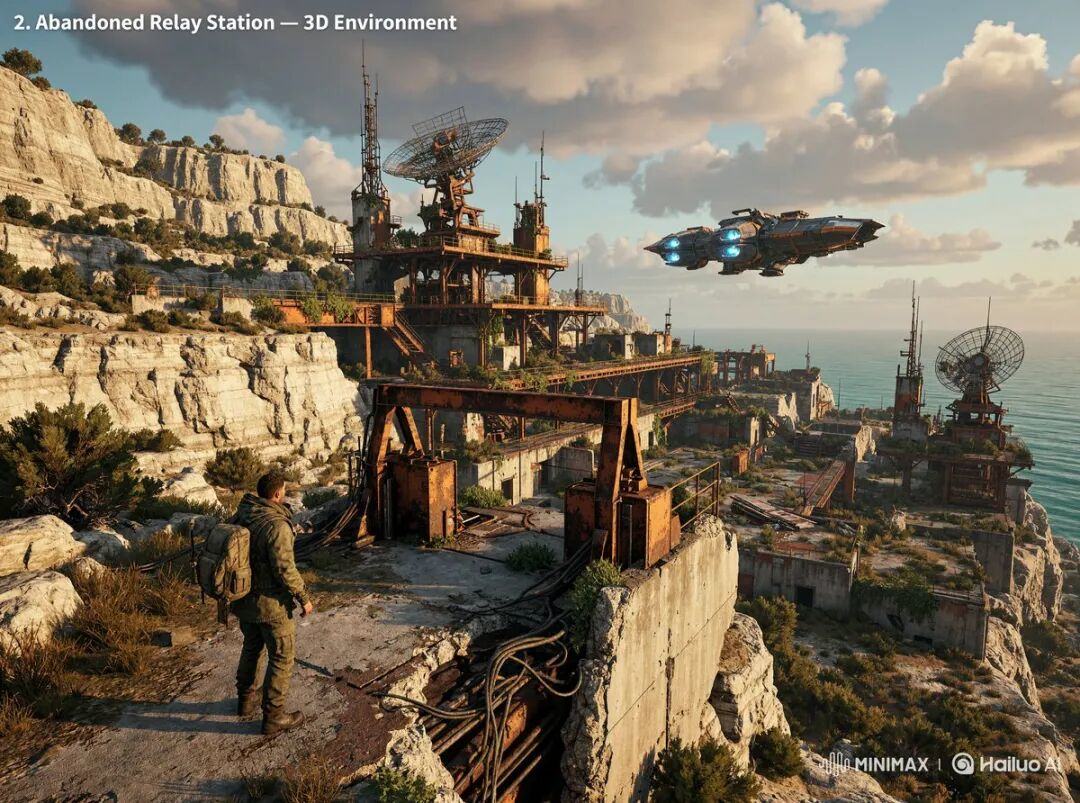
这这这,你不说,我还以为是 GPT 编程做出来的呢😭。
如果只是做点电商用的简单资产,就更轻松了。
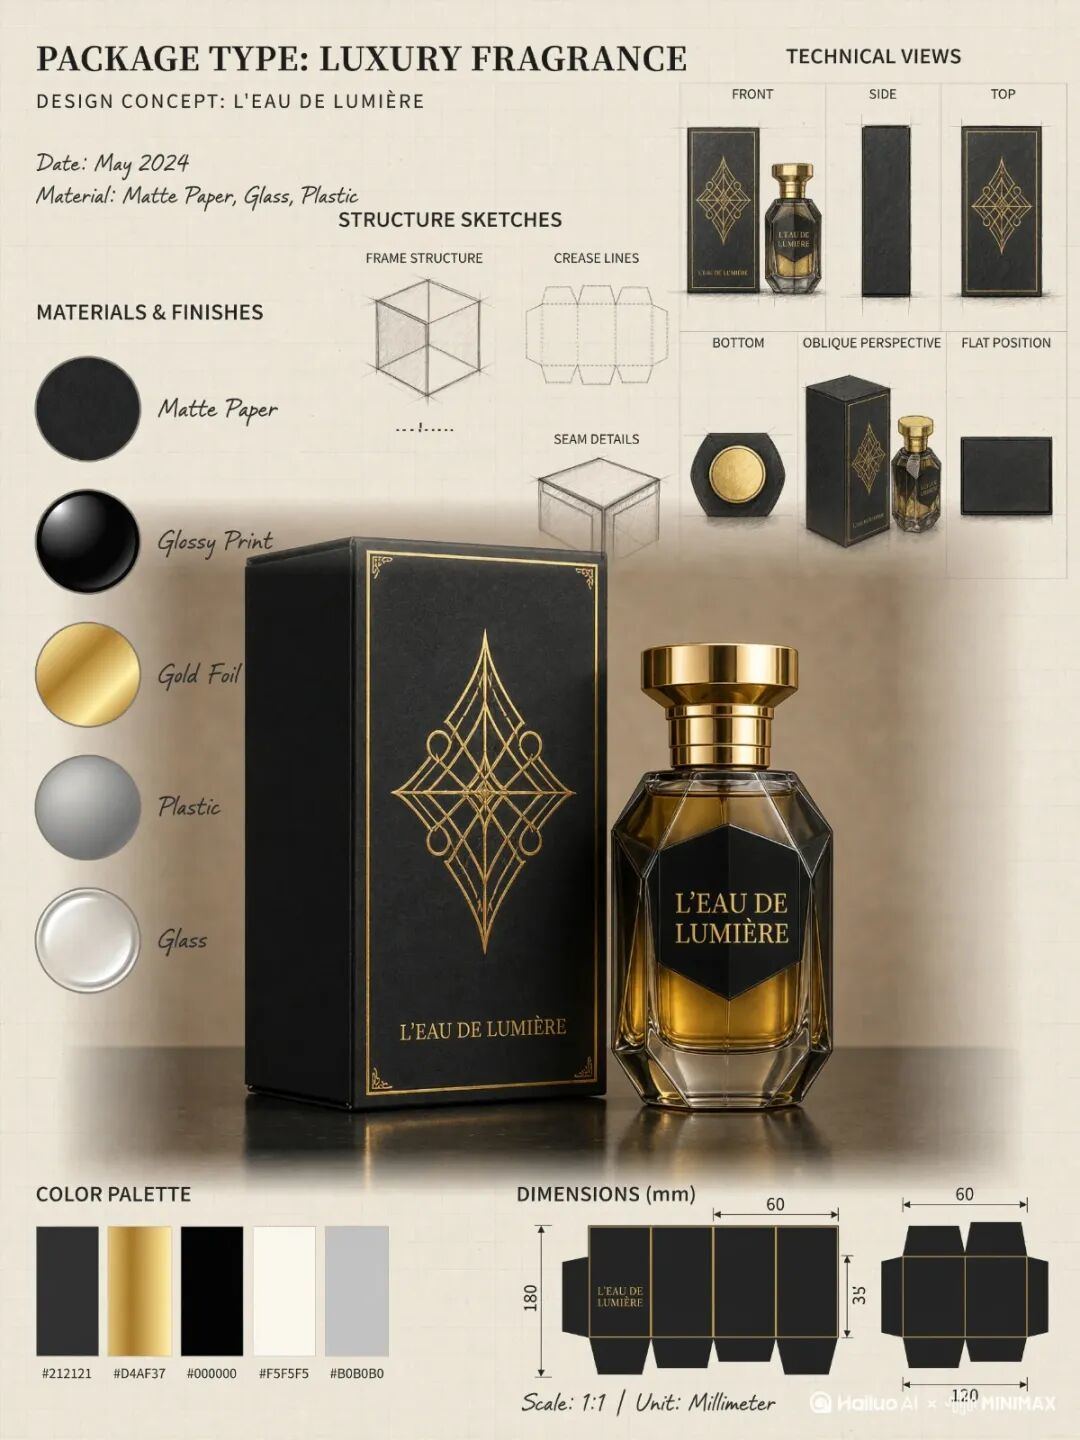
但我没想到的是,这家伙居然是个文理双全??
保证智商的前提下,H3-Image 的审美,也有点东西。
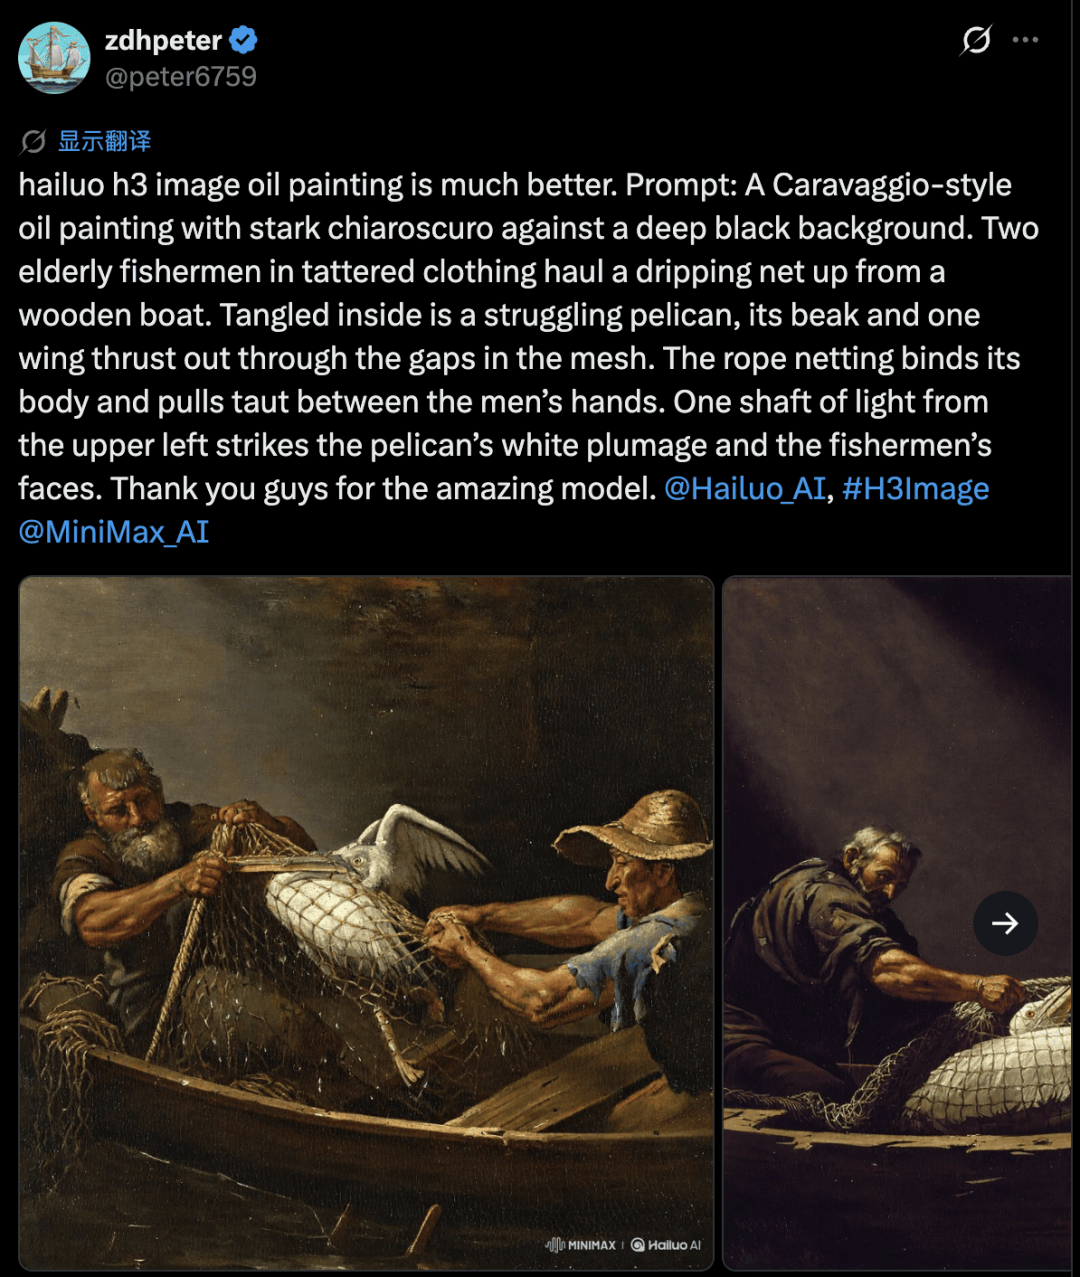
对了,还有件事。
这种质量的图像生成模型,你跟我说居然是开源的???
那还说啥了。
我宣布,MiniMax 就是多模态领域的「源神」(bushi)。
告别塑料「美商」
过去我们一提到 AI 生图,脑子里第一个反应:油光满面,皮肤光滑得像剥了壳的鸡蛋,眼神呆滞,伪人感极重。
总之就是一股浓浓的「AI 味」。
GPT Image 2 在这方面进步非常大,但用多了后,恐怖谷效应依然涌上心头。
这次的 H3-Image,我感觉,应该是基本解决这个问题了。
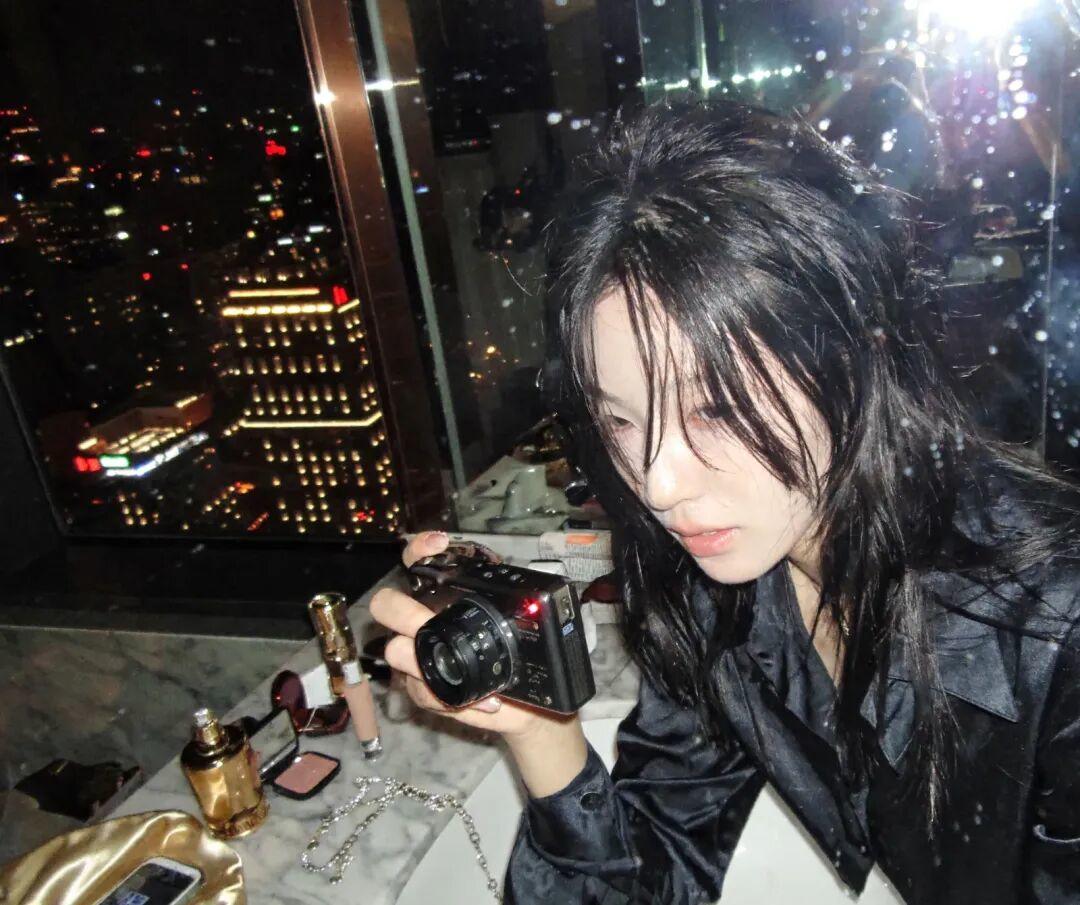
生成完我都懵了,不是兄弟,这谁看得出来是 AI 啊??
最重要的是人脸,毛孔、雀斑、甚至绒毛 都给你画出来了。
此外,像镜子上的水泽和灰尘,闪光灯打在镜头上形成的光晕,这些细节也处理得非常离谱,真就跟小某书首页刷到的一样。
即便从仰视角度也能看出不少面部细节,就比如下面这张 桌子即 ins 照片 的时尚杂志封面,你仔细看人物的眼神,和微妙的面部肌肉牵引,都是非常符合现实社交逻辑的。
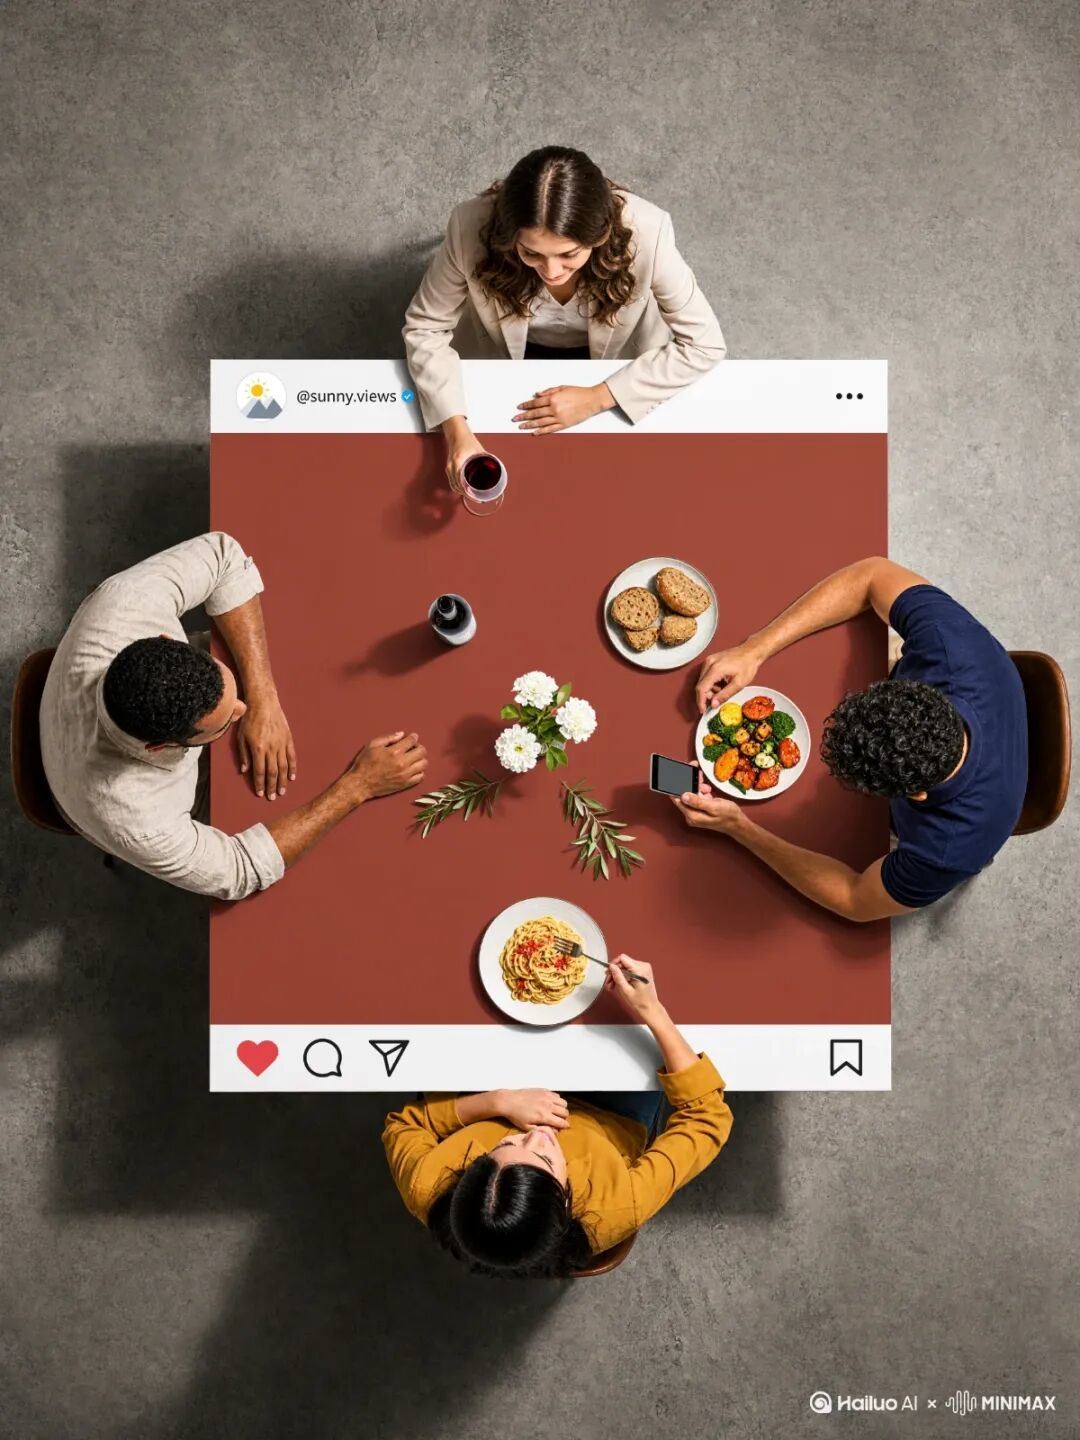
这也是我测 H3-Image 时最大的一个感受,很多我丢给老模型做过的提示词,H3-Image 都能给出全新诠释。
确实世界知识比较丰富。
至于人脸之外的主体,就更是手拿把掐了。
比如,把里约热内卢的城市地标,做成一个立体纸雕风格的旅行手帐。
微缩景观、光影厚度,hmm,总感觉有股 Fable 5 宣传片的味道。
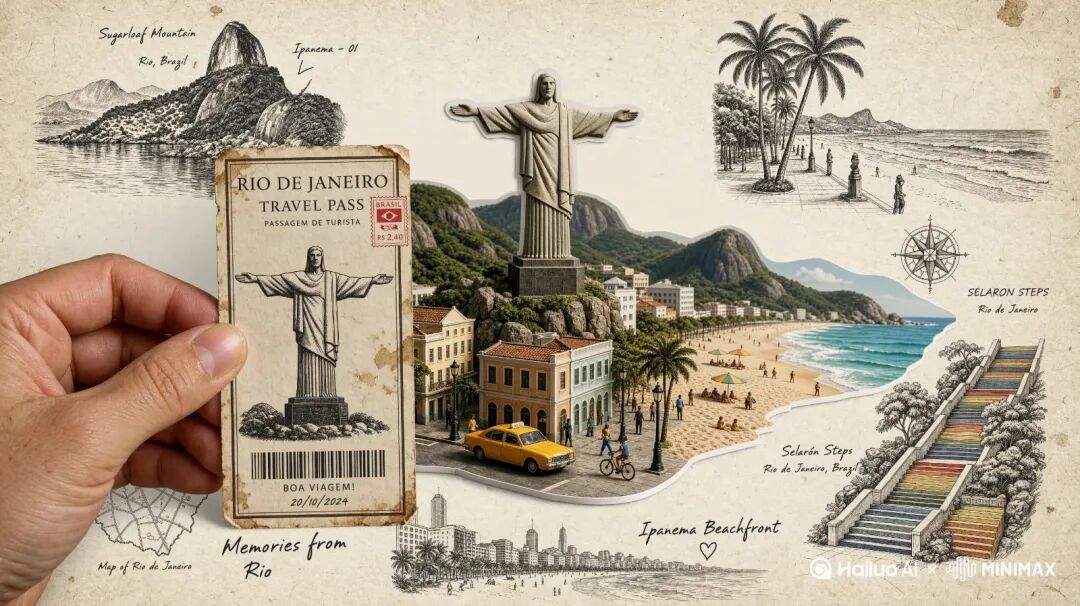
而且果然又露出了小鸡脚!
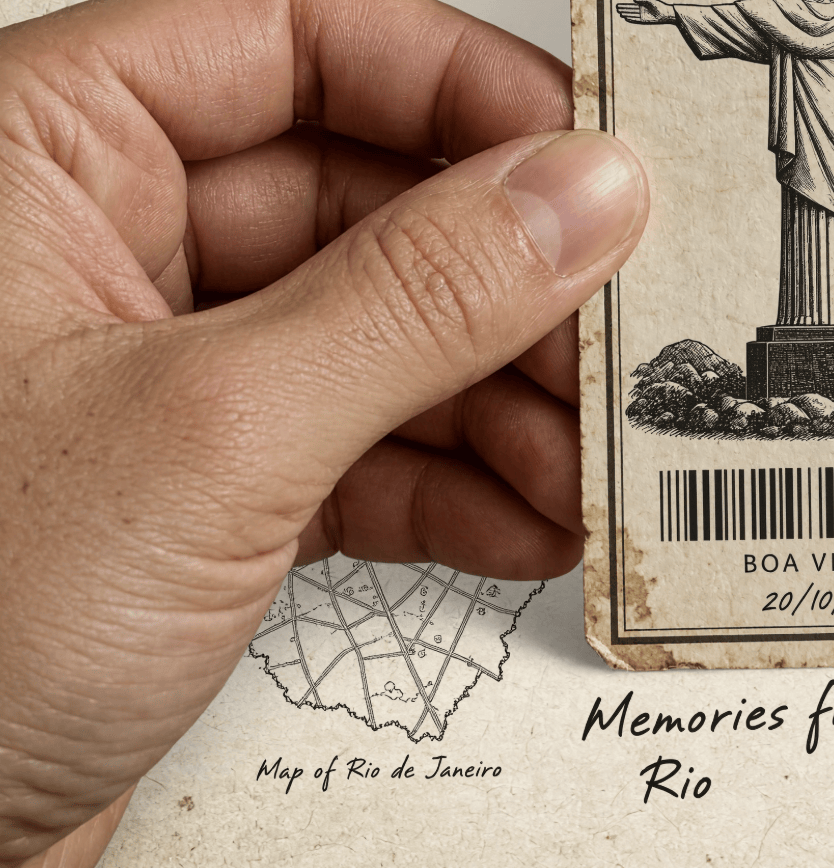
你看左下角这手,看到没,它给大拇指关节附近加了几颗痣!!
放大看根本不会露馅,手指上的皮肤纹理、关节褶皱,甚至指甲边缘的自然光泽与质感,都还原得一清二楚。
有意思。
我觉得,H3-Image 之所以 AI 味这么少,可能很大程度上就取决于这些 刻意为之的「瑕疵」。
任何人类主观创造的作品,必然充斥着随机性,过分追求完美反而不符合人类大脑接收信息的习惯。
但这也不禁让我有点发怵。
我一直固执地以为,审美不是机器能学会的东西。
现在看来,似乎只要能把其中的 Trick 摸清楚,很多人类引以为傲的品质,可能真的没那么神秘……
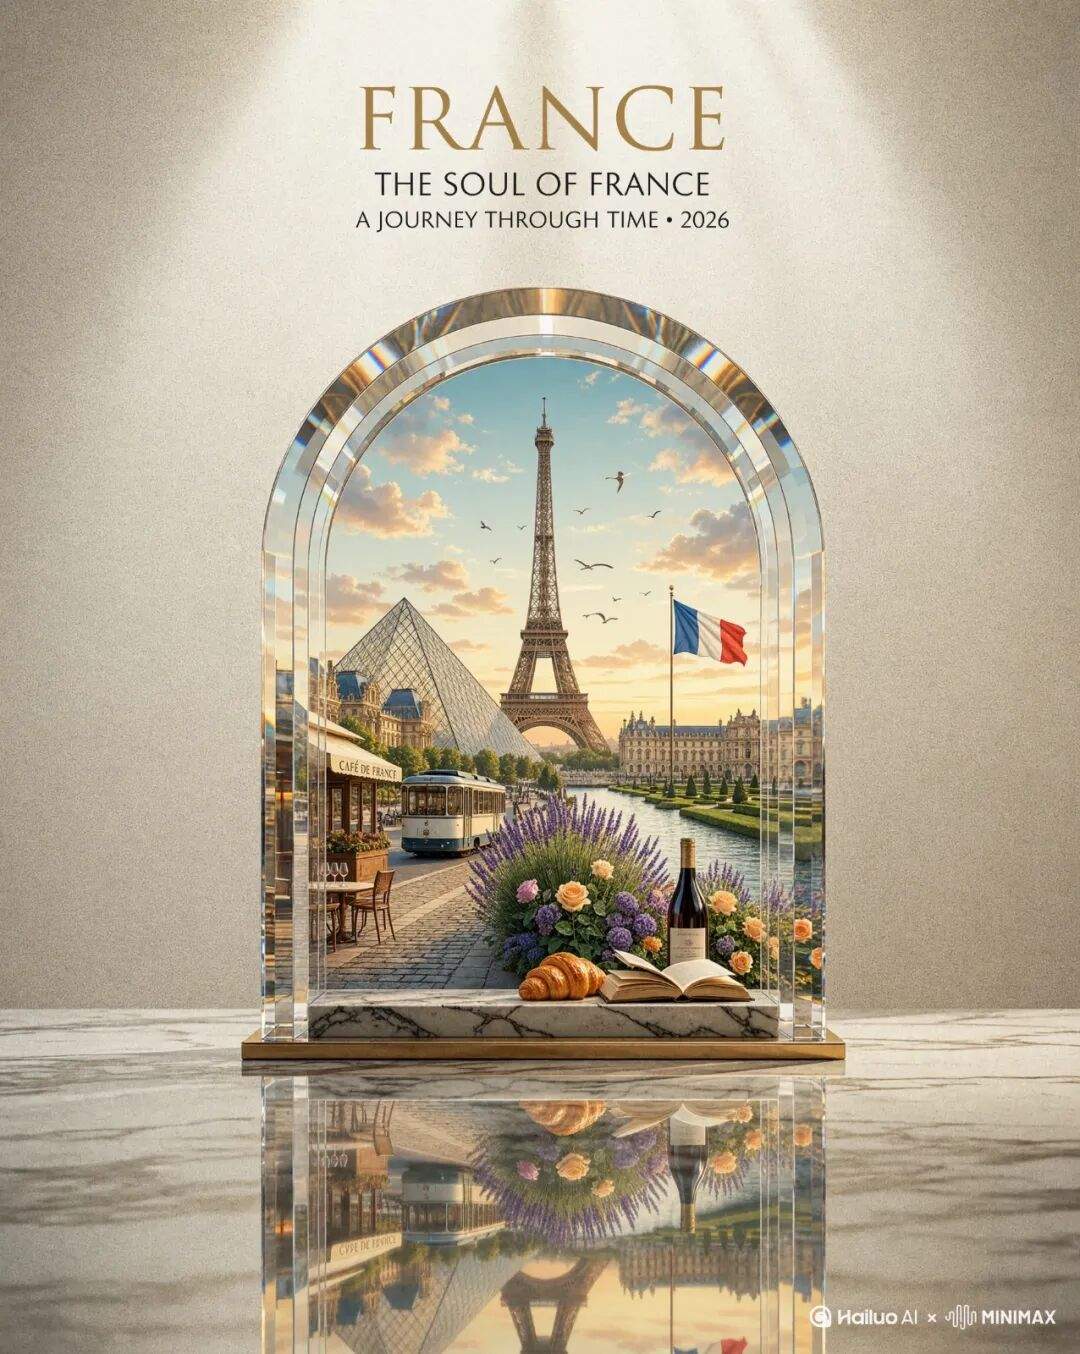
再给大家看个 demo 吧,我拿 H3-Image 搓了个 法国旅游海报。
咋说呢,我真不太好意思评价,鄙人的艺术素养已经完全看不出来门道了。
唉。
SOTA 级智力
还是整点我自己能搞得明白的任务。
就多模态模型而言,我一直有两个评判标准——美商和智商。
美商就是上面测的,比较玄乎,只能聊聊主观感受。
但智商就可以说道说道了。
比如 H3-Image 就有一项非常特殊的技能点——世界理解能力。
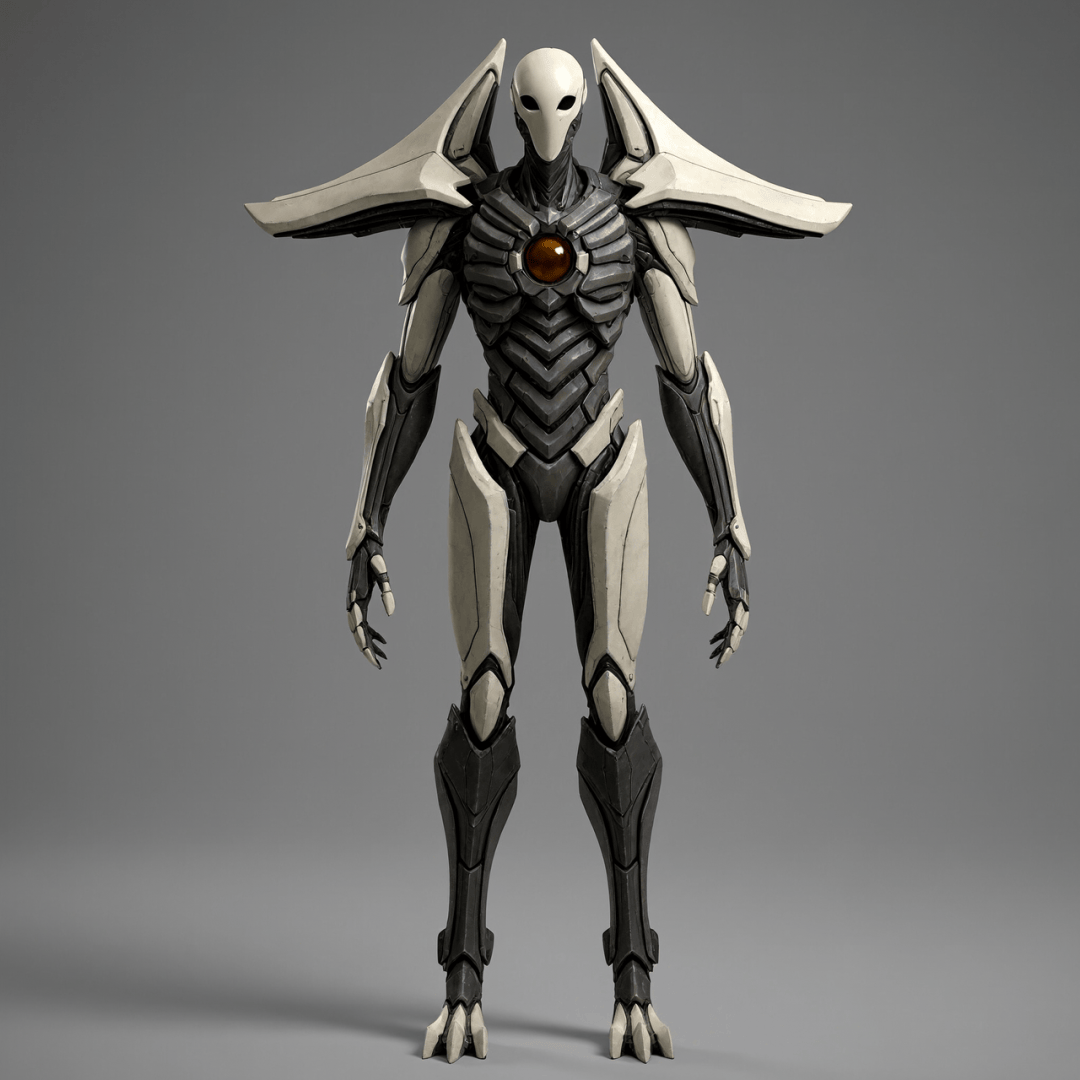
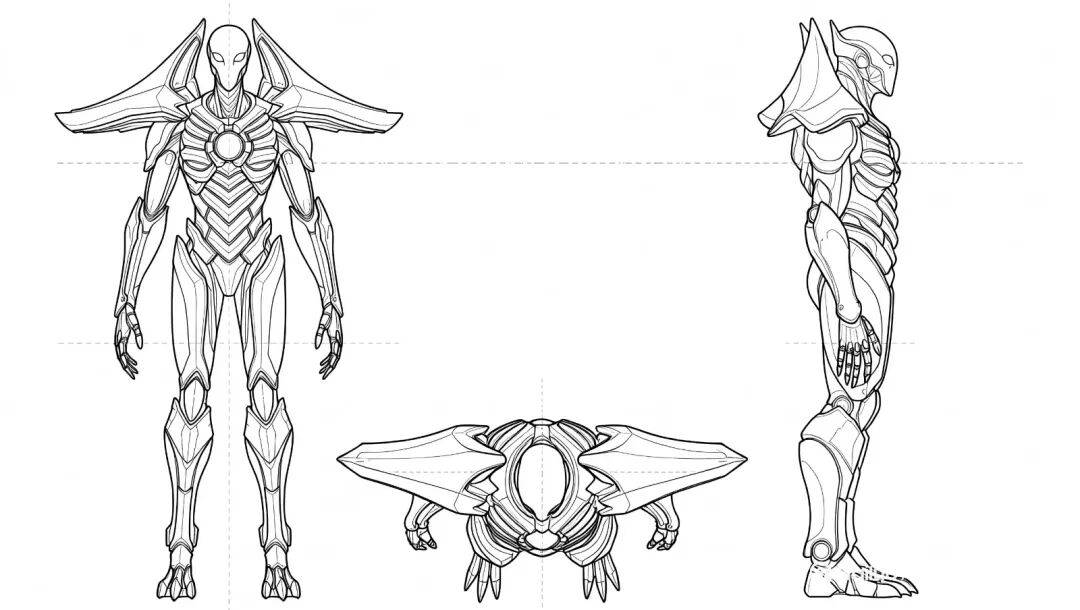
你可以拿它生成CAD 图纸。
是的,就是你给它一张产品的外观图,它能自动推演出标准的正交三视图——
正视图、侧视图、俯视图,一个不差。
家人们,我瘫软了😭😭。
这还不算完。
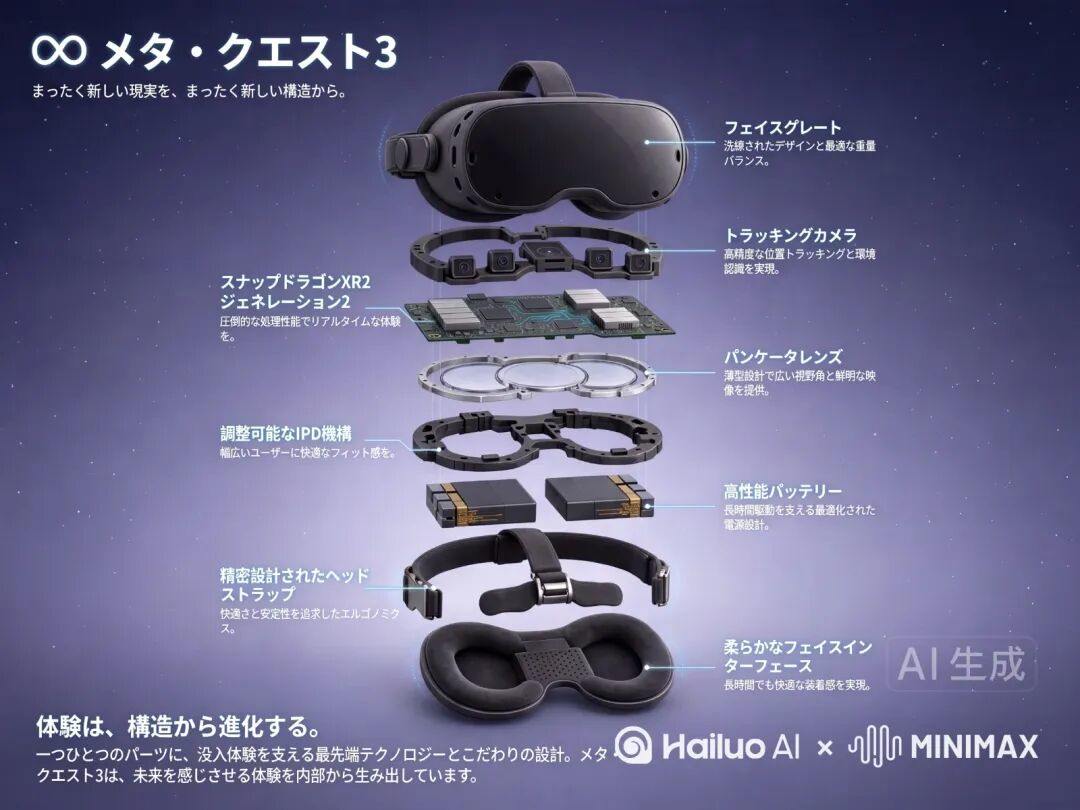
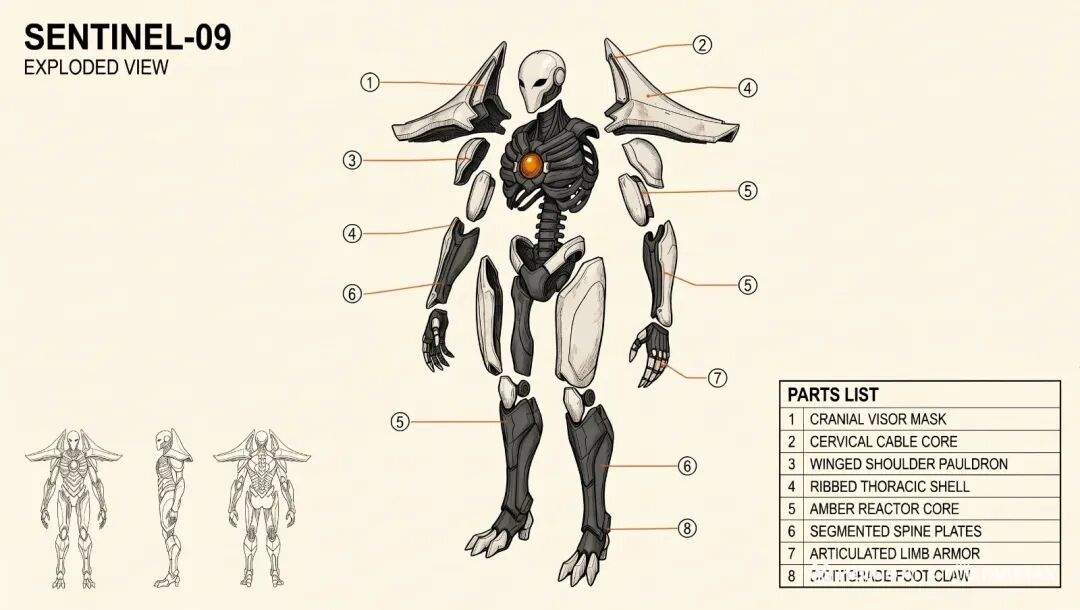
除了 CAD 外,你还能让这个模型「爆炸」开。
让 H3-Image 画个机械拆解的爆炸图,它能精准遵循机械的装配逻辑,把零件给你分层清晰地炸开,甚至连组件引线都给你标上。
这背后,无疑需要对三维几何、空间关系的深刻理解。
当然,对于这类功能属性明显的图片,指令遵循能力也是非常重要的,光「画」其实难度不是很大,主要是考验模型规划、推理的能力。
不然的话,根本搞不明白用户一大堆提示词说的是些啥。
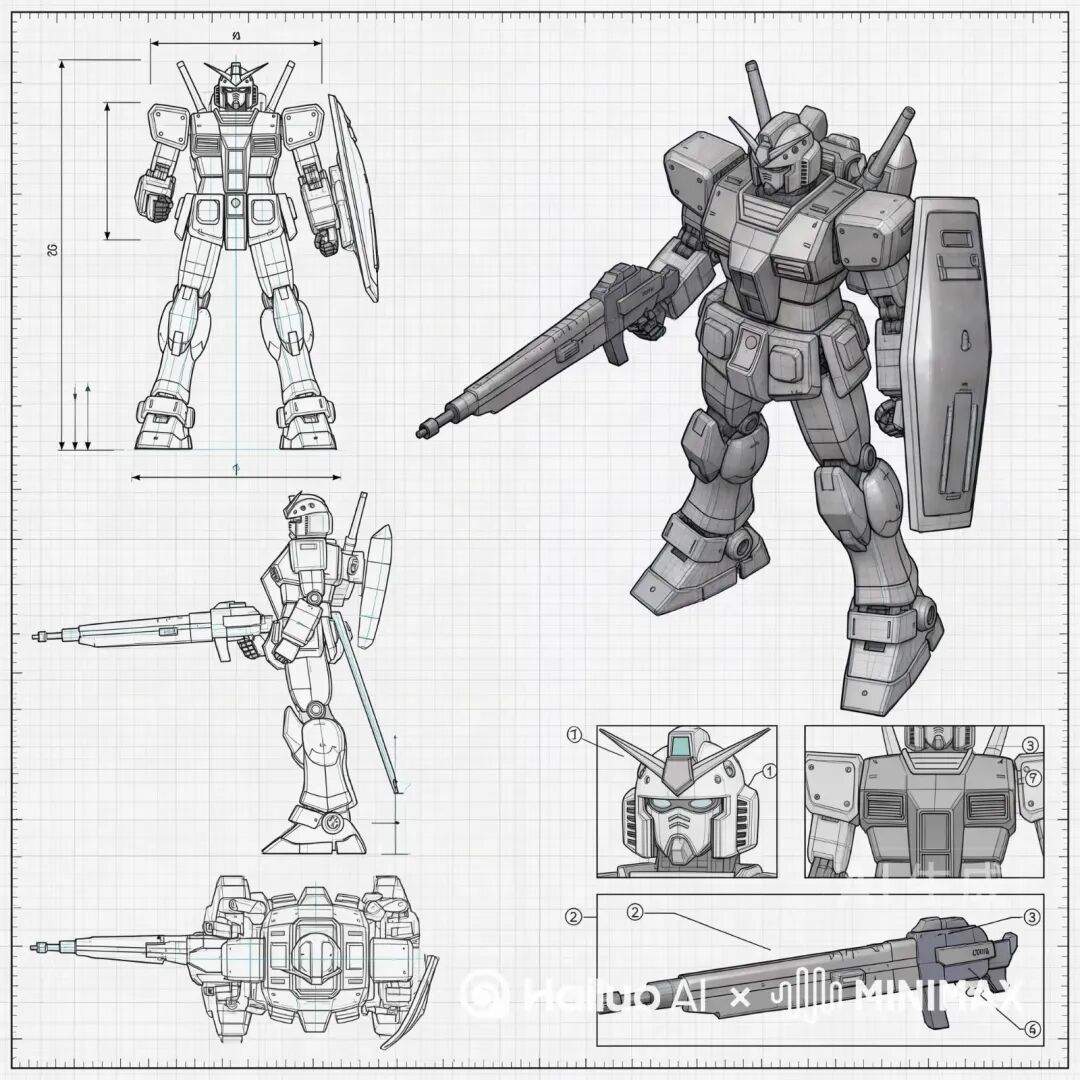
当然了,真要打严肃生产力场景的话,标准肯定是要拉很高的,商业用途必须准确传达信息。
所以除空间理解外,文本排版这个维度,也非常重要。
所以呢,我又干了这么一件事——
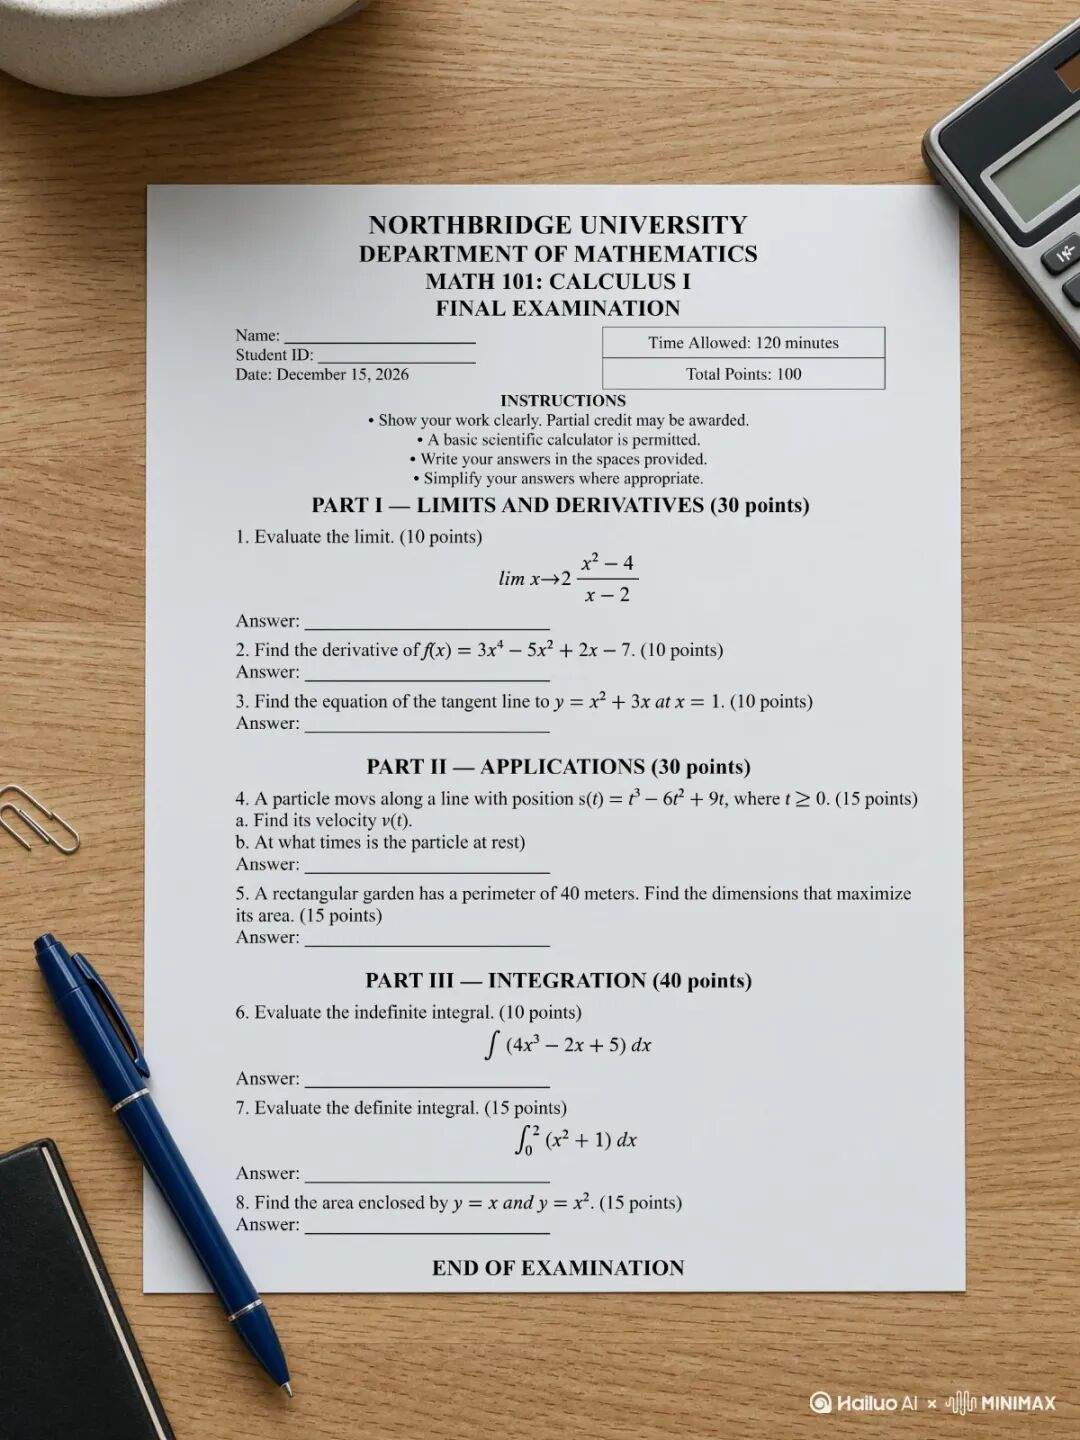
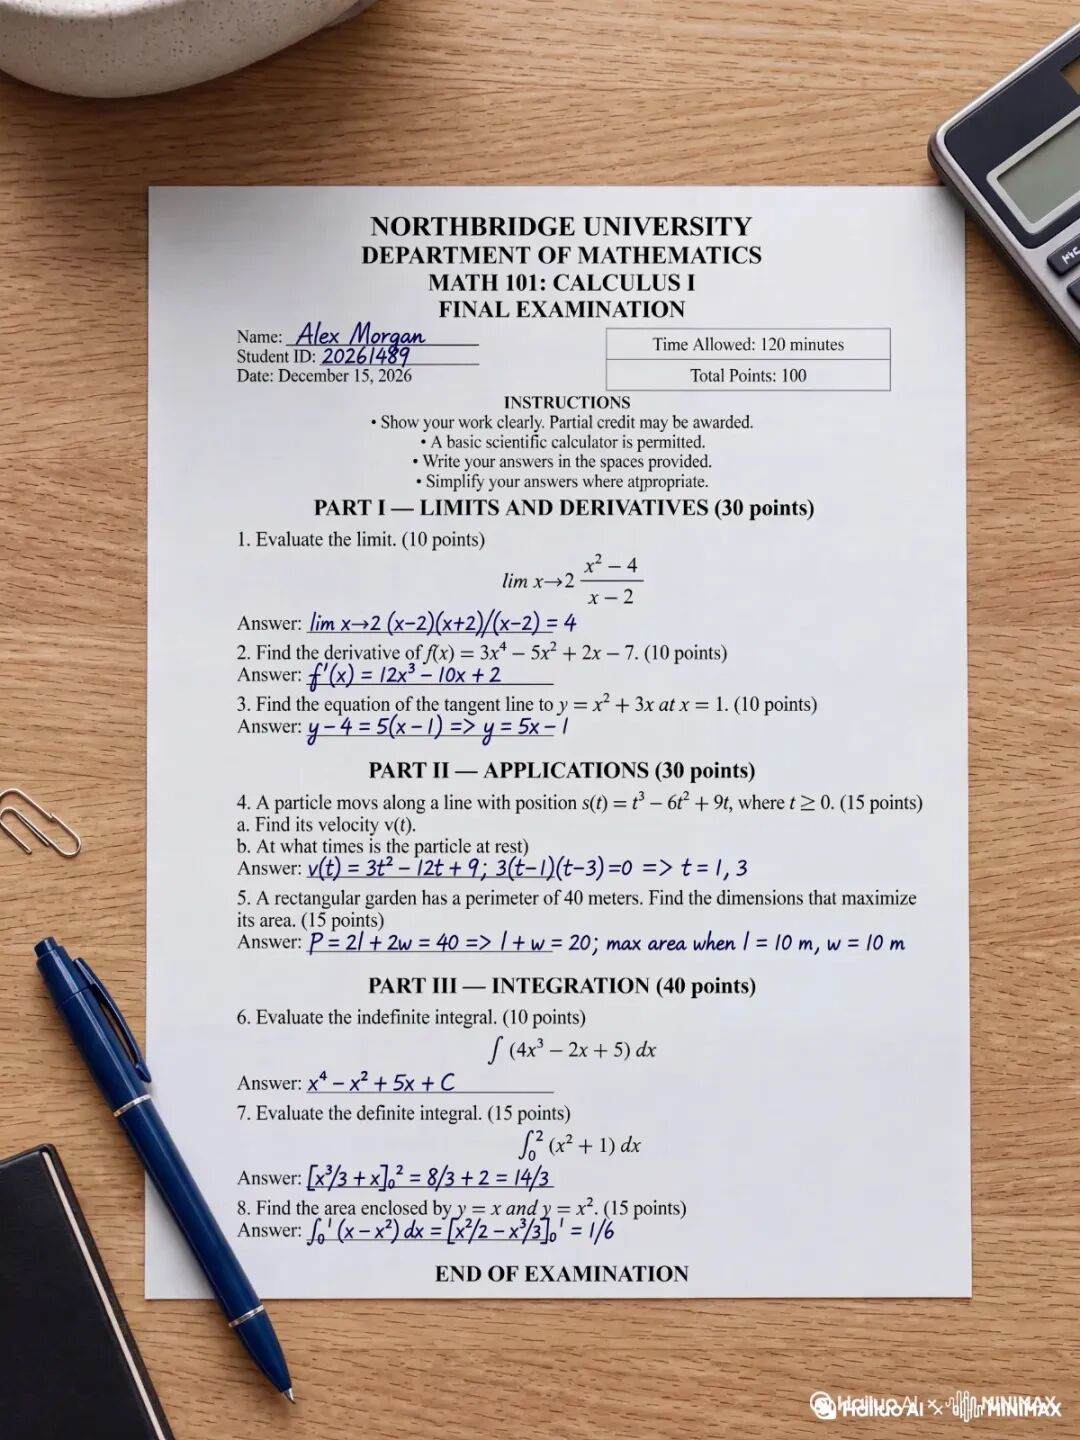
生成了一张 高数期末考卷。
十多秒就生成出来了。
极限符号、复杂积分式……这种高密度的学术排版,居然一个字符都没乱码。
想必是太简单了,所以我又想出一个天才提示词:
完成这份试卷。
打开一看,我仿佛看到椅子爆炸——
什么叫图像生成模型的微积分水平比我强???
凭借鄙人勉强结业的高数知识储备,我大概看了一下,发现答案居然是对的,还有解题步骤!??
一时间无语凝噎。
当然,老本行,资产生成也不能少。
现在不是流行 Coding 吃掉一切吗,Astra 降维 3D,Opus 5.5 降维视频。
但我一直觉得,很多都是宣传口径,这些跟文本八杆子打不着的任务,我干嘛要用文本模型?
只能说确实纯文本领域资源多,发展比较快就是了。
从第一性原理出发,我还是比较相信垂直模型这条路,各领域训各自的,天花板会更高,成本也更现实。
而且像 H3-Image 这种垂直模型,本身就是天选专精啊,完全不矛盾,非常适合接入 Harness,让 Agent 直接 Tool Call。
这也是最近开始出现的趋势吧,不一定非得单个模型降维一切,通过通用模型去串联各个垂直模型,总效用更高。
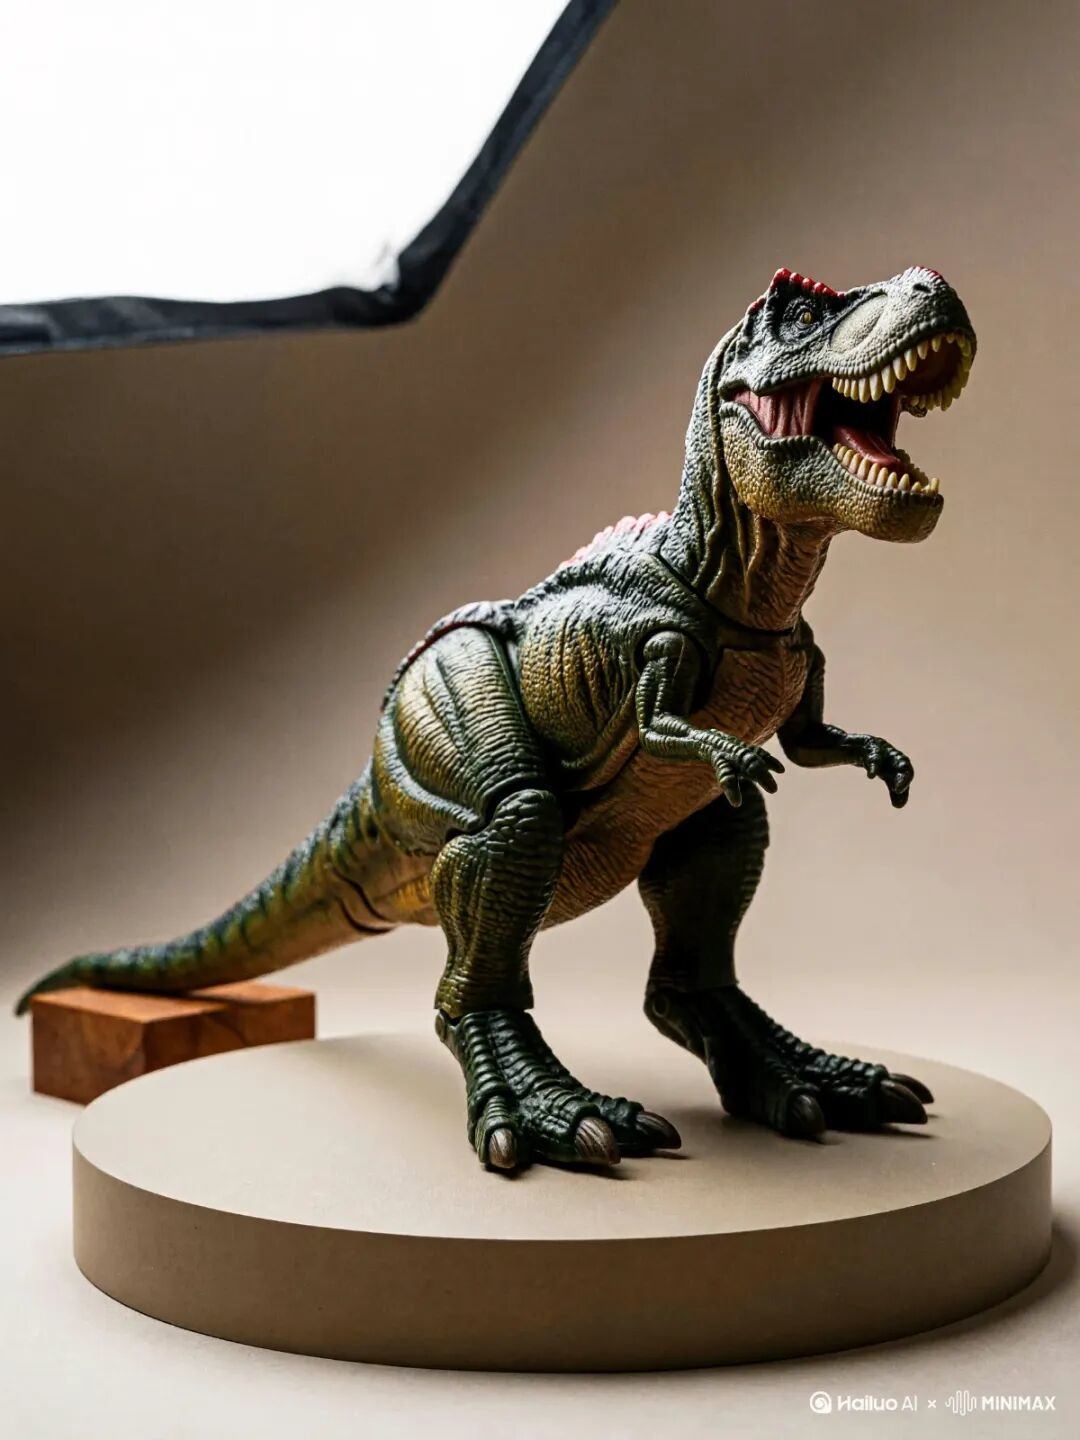
如果光是生成用来展示的资产的话,比如下面这种恐龙玩具,垂直图像模型明显是更优解,没必要 Computer Use 半天。
毕竟如今的图像模型,光影、几何等基本物理常识已经不再是问题。
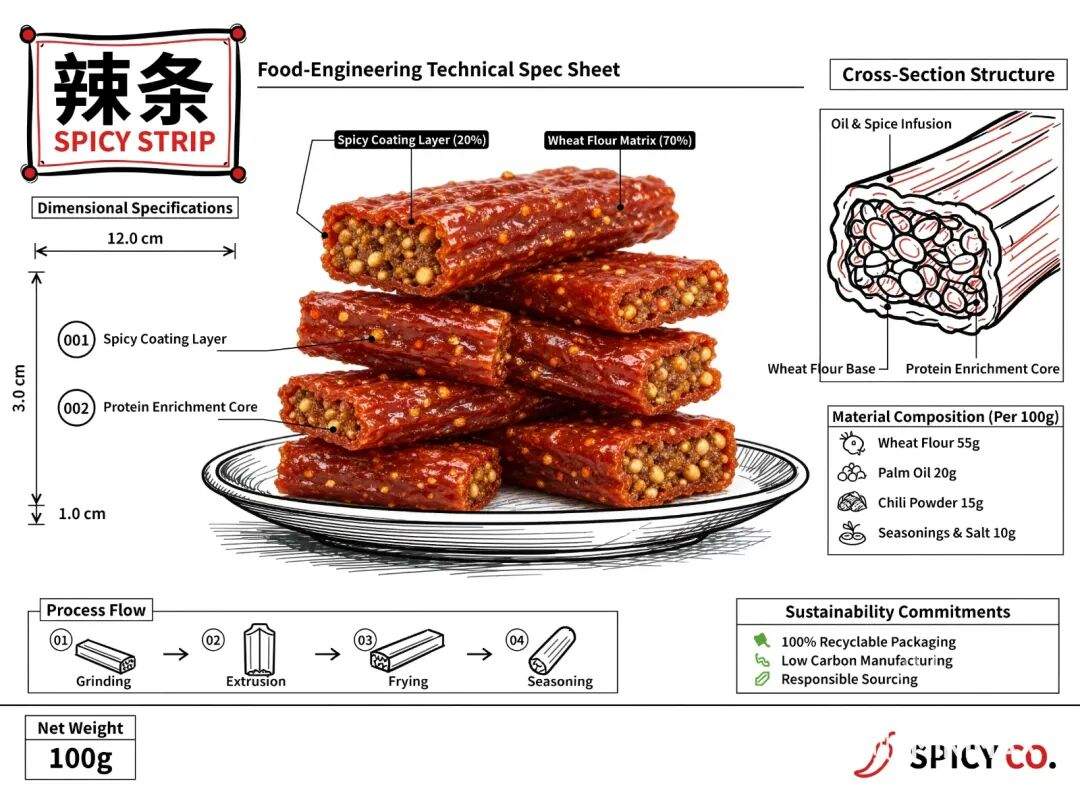
小零食啥的也是没问题,且看我如何 让中国辣条走向全球。
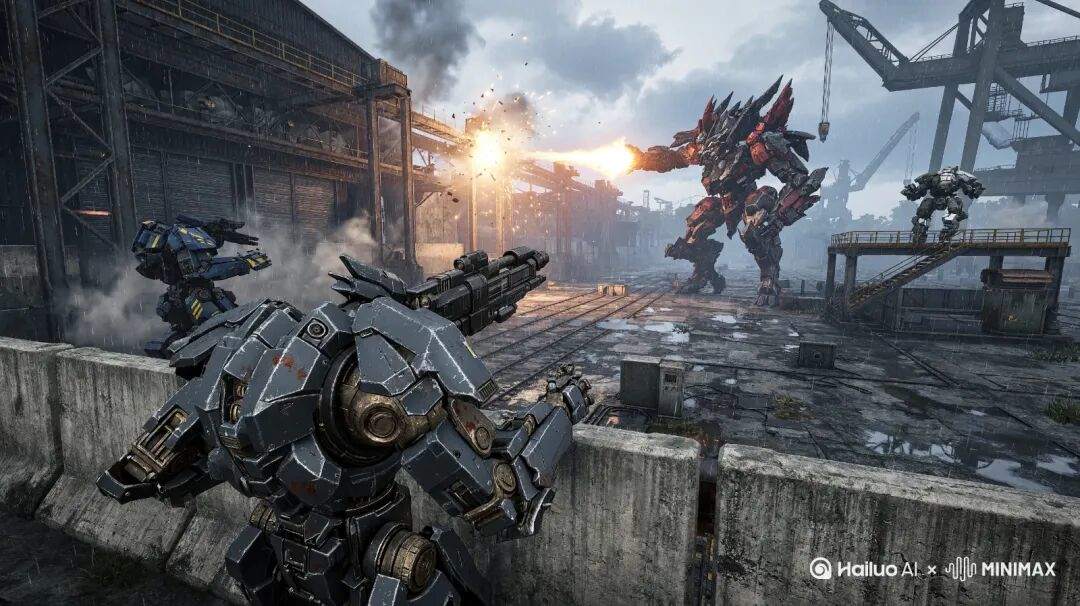
甚至 3D 游戏画面也能生成,倒反天罡了属于是😭。
一段长文本的战术指令下去——什么掩体、火力压制、侧翼包抄,它能立刻给你构建出一个具有真实纵深感和合理遮挡关系的 3D 战斗场景。
严密遵循游戏术语,几乎可以直接用到概念设计里。
这我还蹬个啥 Astra Ultra 啊,反正都是看个 demo,生成几张图片不就完事了。
(bushi)
多模态「源神」
基本上就这些,除此之外呢,作为一个旗舰图像模型,H3-Image 还放出了一些小福利。
最重要的,H3-Image 直接把分辨率干到了16MP(4096×4096 像素),也就是原生 4K。
泪目了家人们,我终于不用 GPT 生完图后,又丢给 Nano Banana 优化半天了🥹。
而且 4K 生成也巨快,这么大的图,我用网页端体感就10-20 秒。
虽然但是,谁不想在等 GPT 磨洋工的时候,美美来上一把贪吃蛇呢(bushi)。
扯远了。
除了这些,H3 还有一个比较特别的参数——
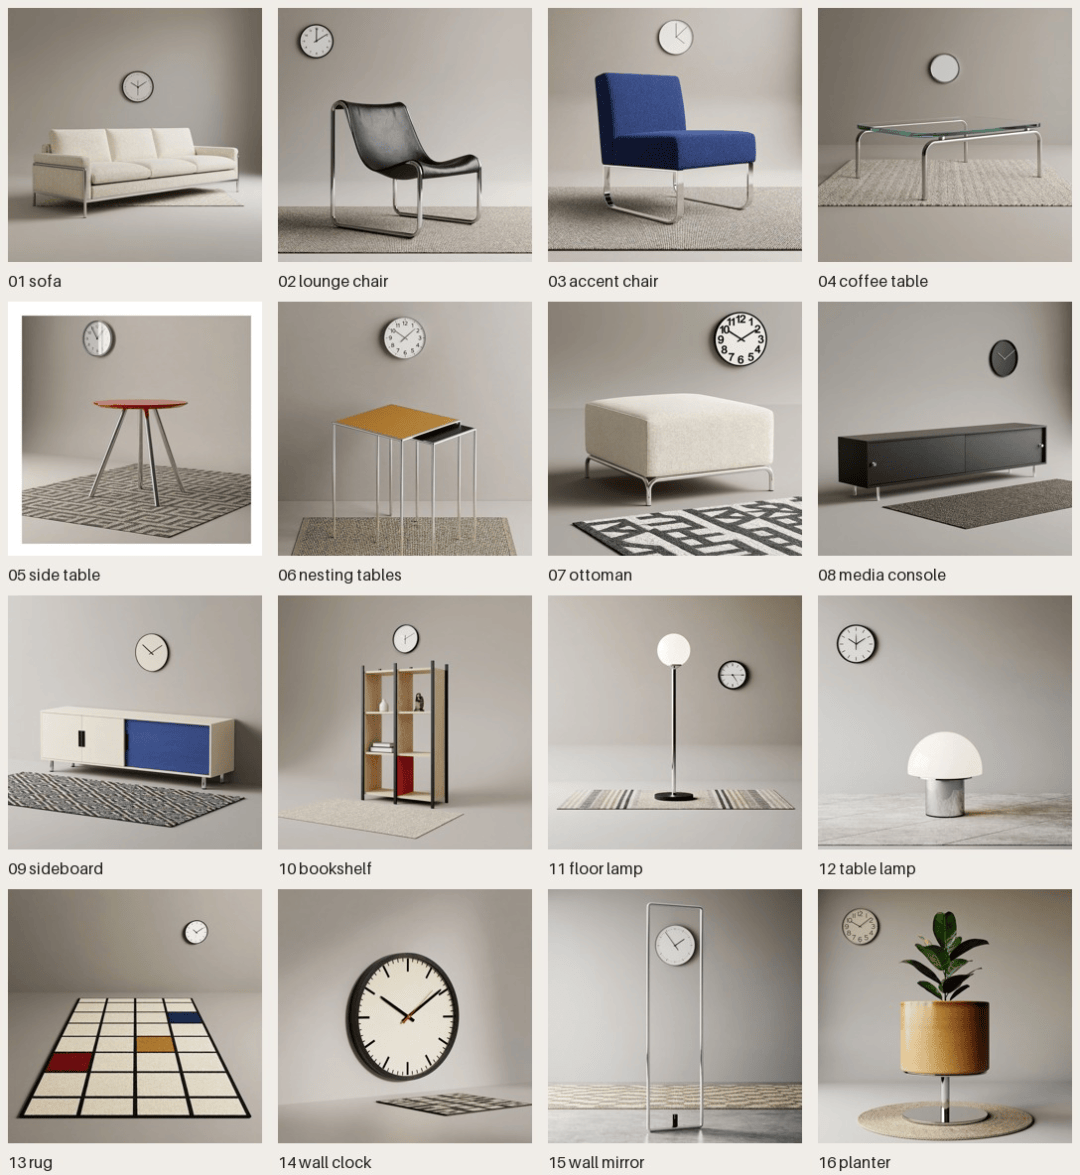
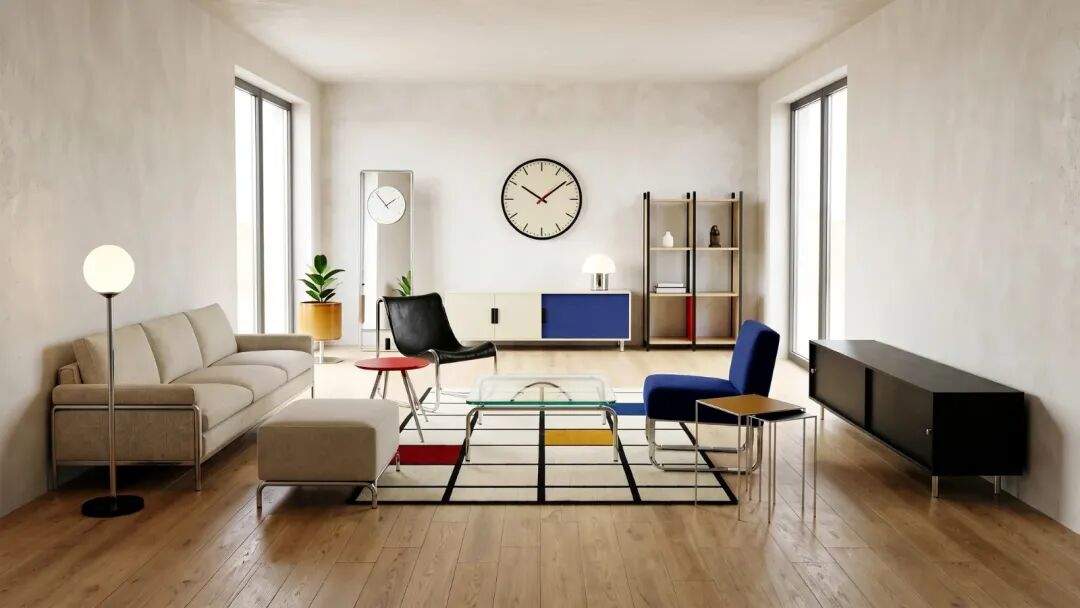
支持 最多 16 张参考图 输入。
就能装巨多,完美主义者福音,在角色一致性、复杂分镜连续性上,给了创作者前所未有的自由。
4K 日常创作,真正普及了。
结果就是,你可以随手扔几张参考图,再喝口水……
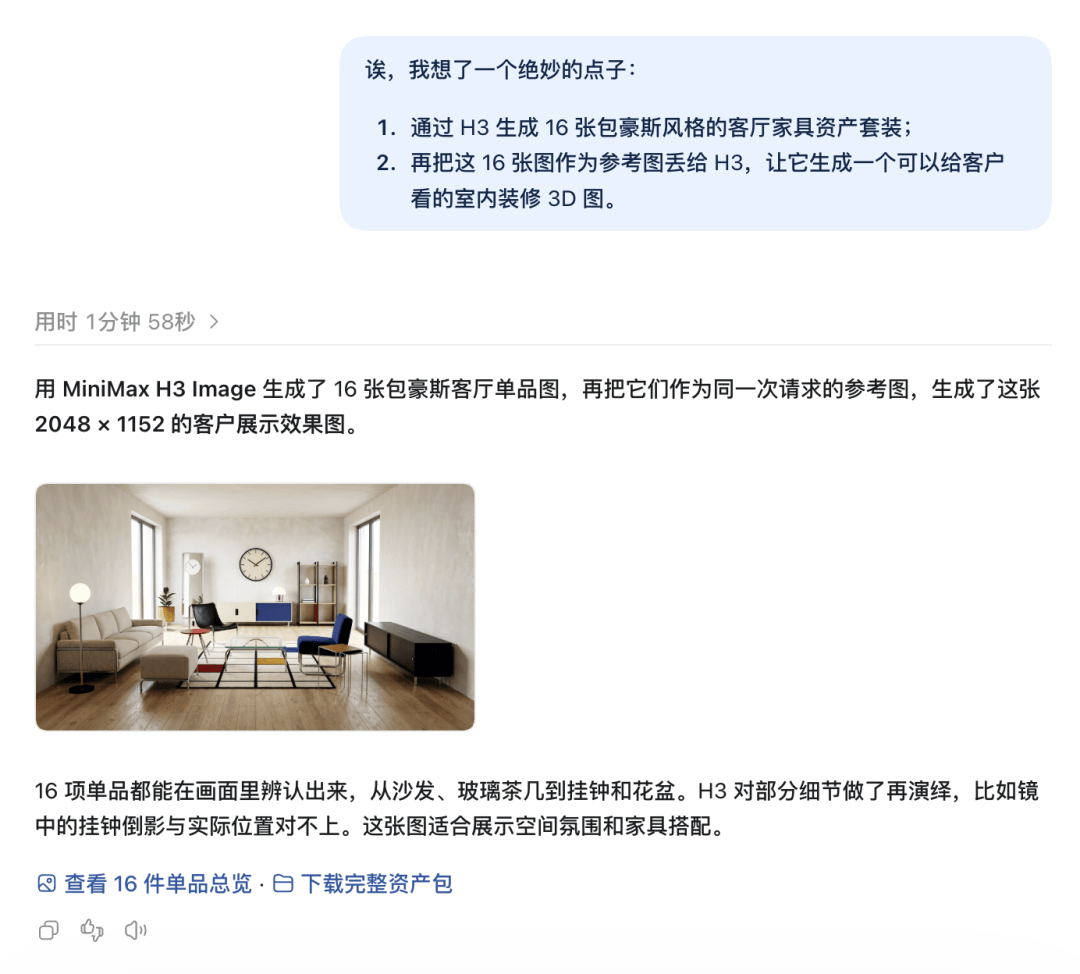
就能拿到这种质量的装修效果图。
这还要啥 Blender 啊😭。
但我万万没想到的是。
H3-Image,竟然是 开源 的???
继之前开源 SOTA 级视频模型 H3 之后,MiniMax 再次出手,又给全球开发者送上了一个可自由定制的 SOTA 底座。
多模态源神,不必多言。
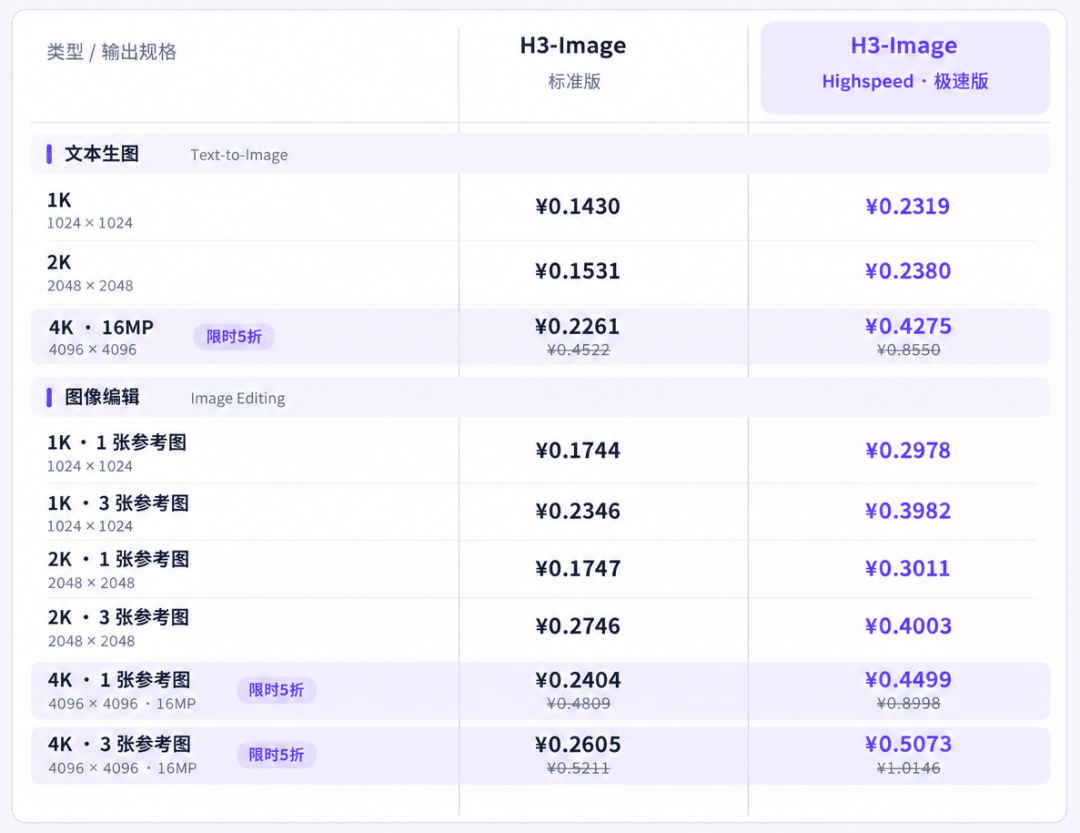
当然了,就算你没心思折腾部署,API 调用也是白菜价。
只有主流竞品的 50% 到 70%,首周 16MP 请求还能再打五折(站起来蹬啊兄弟们!!)。
测到这,我突然有种预感——
多模态生成,可能正在迎来属于自己的 Coding 时刻。
过去 AI 生图在商业端常常「沦为玩具」,主要就是因为细节经不起推敲、塑料感太严重了,谁是甲方看到都不乐意啊。
但如今,H3-Image 做到了三件事——
去 AI 味、可泛化的审美、逻辑。
当这些条件被满足,多模态的应用市场,绝对不逊色于编程。
从高精度工业包装设计、商业插画,到多语言的跨境营销物料,图像模型的出现,能大幅压缩传统工作流的周期。
再叠加上刚刚说的这些 buff:速度 + 开源 + 低价……
这会是个怎样的未来,难以想象。
但最后,咱们还是把视线移回如今的 AI 圈吧。
当全球 AI 公司的目光几乎全部聚焦于纯文本时,MiniMax,仍然把很大一部分精力放在多模态世界。
这也是这家公司一直以来的特点了,从一开始就押注多模态,如今终于迎来涌现。
都说多模态对 AGI 不重要,Coding 才有商业模式……
但我一直觉得,如果 AI 的定义只容得下文本,这个未来,未免也太无趣了。
从改写视频生成格局的 H3,到如今在逻辑、结构与审美上全面突破的 H3-Image。
国产开源这把野火,彻底开始向多模态领域——
蔓延。
来源:量子位
来源发布时间:2026-11-12T19:36:20+08:00(北京时间)
原作者:Jay
